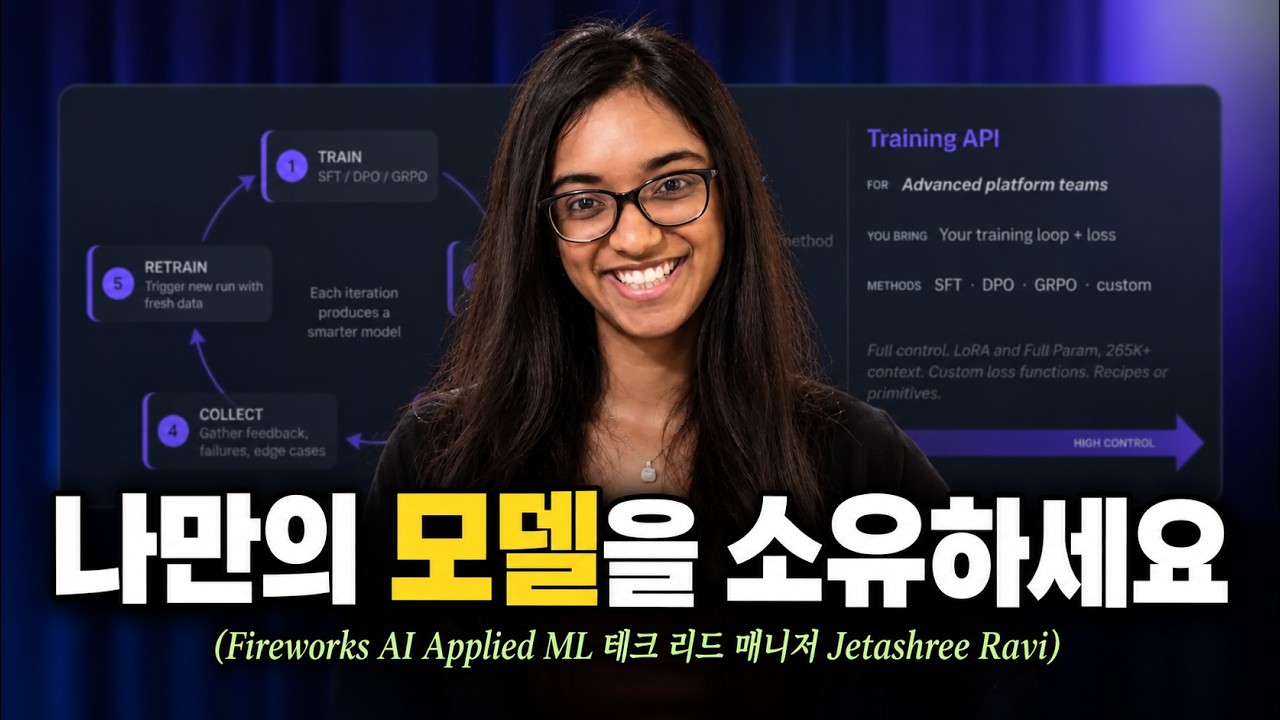
원문 제목: [한영자막] 지능을 빌리는 건 그만: 특화 AI의 학습부터 배포까지
URL: https://www.youtube.com/watch?v=Eu4D795nMsQ
날짜: 2026-10-13
채널: Tech Bridge
발표자: Jetashree Ravi, Fireworks AI Applied ML Tech Lead Manager
발표 맥락: AI Engineer World's Fair 2026, San Francisco
📌 핵심 질문 / 특화 AI의 경쟁력은 어디에서 만들어지는가
==폐쇄형 모델의 지능을 계속 빌려 쓰는 대신, 오픈 모델을 자체 데이터로 학습하고 같은 플랫폼에서 배포·관찰·재학습하는 순환 구조를 만들 수 있는가?==
- 오픈 모델은 이미 상당수의 실서비스, 특히 코딩 용도에서 생산 환경에 투입할 수준에 도달했다.
- 폐쇄형 모델에서 오픈 모델로 옮길 때 남는 가장 큰 장벽은 비용이 아니라 품질이며, 자체 데이터와 평가 함수로 커스터마이즈하면 그 격차를 줄일 수 있다.
- 모델을 한 번 서빙하고 끝내지 않고, 학습→배포→관찰→피드백→재학습을 반복해야 품질 개선이 실제 서비스에 축적된다.
핵심은 최고의 기본 모델을 한 번 고르는 일이 아니다. 고객별 데이터와 사용 패턴에 맞춰 빠르게 학습하고, 추론 성능을 맞추고, 중단 없이 새 가중치를 배포하며, 운영 데이터로 다음 학습을 이어 가는 시간이 경쟁력이 된다.
1. 폐쇄형 모델에서 오픈 모델로 이동하는 이유
비용 상승이 이동을 촉발하지만, 품질을 유지하지 못하면 전환은 멈춘다.
1.1. “지능을 빌리는” 모델의 비용 문제
-
폐쇄형 모델 사용료의 압박
- 빠르게 커지는 비용: ChatGPT나 Anthropic 같은 폐쇄형 모델을 사용하는 조직은 사용량이 늘수록 토큰 비용이 급격히 커진다고 느낀다.
- 전환 의지는 있으나 출구가 불분명함: 현장에서 폐쇄형 모델을 사용하면서 비용이 “정말 빠르게 비싸지고 있다”고 느끼는 사람이 많지만, 오픈 모델로 옮겼을 때 품질을 보장할 운영 수단은 부족하다.
-
오픈 모델이 제공하는 선택지
- 통제권과 비용 구조: 자체 인프라나 전문 플랫폼에서 오픈 모델을 운영하면 사용량에 따른 폐쇄형 API 의존을 줄이고 모델·데이터·배포 방식을 통제할 수 있다.
- 기본 성능의 상승: GLM 5.2 같은 최신 오픈 모델은 특히 코딩 작업에서 생산 환경에 투입할 수 있는 수준에 가까워졌다.
1.2. 실제 병목은 품질이다
-
평가 단계에서 드러나는 격차
- 엣지 케이스 처리: 오픈 모델은 특정 예외 상황에서 폐쇄형 모델보다 덜 안정적으로 답할 수 있다.
- 환각과 뉘앙스: 약간 더 많은 환각이 발생하거나, 사용자가 익숙해진 답변의 뉘앙스를 놓치는 차이가 전환을 막는다.
-
품질 격차의 원인은 학습과 커스터마이즈
- 기본 모델만의 문제가 아님: 오픈 모델이 폐쇄형 모델과 같거나 더 나은 품질을 내지 못한다면, 차이를 만드는 것은 기본 모델보다 어떻게 커스터마이즈하고 학습하며 개선하는가에 있다.
- 새로운 해자: 모델 자체가 점점 상품화되면, 특정 업무에 맞는 데이터를 넣고 평가하고 반복 학습하는 과정을 가장 쉽고 빠르고 안정적으로 만드는 플랫폼이 차별화 요소가 된다.
2. Fireworks AI가 제시하는 세 가지 사실과 역할
Fireworks AI는 모델 하나를 제공하는 데서 그치지 않고, 학습과 추론을 하나의 운영 루프로 연결하는 플랫폼을 지향한다.
2.1. 오픈 모델에 관한 세 가지 사실
-
오픈 모델은 대부분 생산 준비가 끝났다
- GLM 5.2의 사례: GLM 5.2를 사용해 본 사람이라면 오픈 모델이 생산 환경에서 동작할 수 있다는 점을, 특히 코딩 유스케이스에서 확인할 수 있다는 주장이다.
- 조건부 표현: “대부분(for the most part)”이라는 단서가 붙으므로 모든 도메인에서 폐쇄형 모델과 동등하다는 뜻은 아니다.
-
남은 품질 격차는 커스터마이즈로 줄인다
- 자체 데이터의 역할: 실제 사용자의 질문, 실패 사례, 도메인 규칙을 학습 데이터로 반영하면 범용 모델의 약점을 업무별로 보완할 수 있다.
- 학습 설계의 역할: 데이터 정제, 하이퍼파라미터, 평가 함수, 반복 횟수를 함께 설계해야 단순한 파인튜닝 이상의 품질 개선이 나온다.
-
AI 스택은 일회성 서빙에서 연속 루프로 이동한다
- 기존 방식: 모델을 선택하고 한 번 호스팅한 뒤 운영을 별개 문제로 다루는 구조다.
- 새 방식: 학습한 가중치를 즉시 배포하고, 토큰 사용량·캐시 적중률·추론 지연과 사용자 피드백을 관찰한 다음, 체크포인트에서 다시 학습하는 구조다.
2.2. Fireworks의 위치
-
학습과 추론을 분리하지 않는 플랫폼
- 품질과 성능의 동시 최적화: 모델을 학습한 환경과 서빙 환경의 수치 연산을 맞춰 품질 저하를 줄인다.
- 반복 비용의 절감: 새 체크포인트를 배포하는 데 별도의 마이그레이션 프로젝트를 만들지 않고 버튼 한 번으로 루프에 다시 넣는다.
-
사용자 숙련도에 맞춘 제품 계층
- 비전문가 접근성: 모델을 한 번도 학습하지 않은 제품 관리자와 빌더도 자연어 목표에서 시작할 수 있다.
- 전문가 제어: ML 엔지니어는 관리형 학습이나 API를 통해 하이퍼파라미터, 손실 함수, 사용자 정의 학습 루프를 직접 제어한다.
3. 규모와 고객 사례가 보여 주는 운영 문제
Fireworks가 제시한 수치는 플랫폼의 규모를 보여 주지만, 모두 회사 측 발표 수치라는 점을 함께 고려해야 한다.
3.1. 플랫폼 규모
-
처리량
- 일일 토큰: GLM 5.2가 출시되기 전 기준으로 하루 약 30조(trillion) 토큰을 처리한다고 제시했다.
- 요청량: 초당 약 20만(200,000) requests per second를 처리한다고 설명했다.
-
고객과 회사 규모
- 고객 수: 10,000개가 넘는 기업이 플랫폼을 사용한다.
- 자금·인력: Series C에서 3억 2,700만 달러를 조달했고, 인력은 약 200명 규모로 소개됐다.
-
GLM 5.2 이후의 추정
- 추가 증가 전망: GLM 5.2 출시 뒤 토큰 처리량이 하루 최소 5조 토큰 정도 더 늘었을 것이라고 추정했다.
- 수치의 성격: 5조 증가는 측정된 실적이 아니라 발표자가 보수적으로 잡은 추정치다.
3.2. Cursor, Vercel, Genspark
-
Cursor의 Composer 2
- 접근: Composer 2 모델을 Fireworks에서 학습하고 호스팅했다.
- 결과: FireAttention을 활용해 추론 속도가 13배 빨라졌다고 제시했다.
- 의미: 같은 모델을 더 빠르게 제공하면 품질을 바꾸지 않고도 사용자 경험과 단위 비용을 개선할 수 있다.
-
Vercel
- 요구사항 입력: Vercel은 입력 토큰 수, 출력 토큰 수, 프롬프트 캐시 적중률, 목표 지연시간을 구체적으로 제시한다.
- 접근: 그 워크로드 프로파일에 맞춰 모델뿐 아니라 커널과 서빙 스택 전체를 조정했다.
- 결과: 지연시간이 40배 개선됐다고 소개했다.
-
Genspark
- 문제: 프롬프트만으로 시스템을 설계하는 서비스에서 폐쇄형 모델에서 오픈 모델로 옮길 때 품질이 큰 병목이었다.
- 접근: 데이터 정제, 평가 함수 정의, 하이퍼파라미터 조정, 강화학습 기반 파인튜닝(RFT)을 결합하고 반복했다.
- 결과: 품질이 12% 향상됐다.
- 핵심 해석: 12%의 개선은 기본 모델이 저절로 좋아져서가 아니라, 평가와 보상 신호를 포함한 학습 루프가 제대로 구축됐기 때문에 가능했다.
4. FireAttention으로 추론을 워크로드에 맞추기
모델을 GPU 위에 올리는 번역 계층이 실제 지연시간과 비용을 좌우한다.
4.1. 범용 커널과 맞춤형 CUDA 커널
-
모델과 GPU 사이의 계층
- CUDA 커널: 모델 연산은 GPU에서 실행되며, CUDA 커널이 모델 연산을 하드웨어 동작으로 번역한다.
- 일반적 선택: 많은 추론 제공자는 범용으로 만들어진 기성 커널을 사용한다.
-
FireAttention의 방식
- 자체 엔진: Fireworks는 FireAttention이라는 사내 추론 엔진을 만들고 자체 CUDA 커널을 작성한다.
- 고객별 튜닝: 고객의 입력·출력 토큰 분포, 캐시 적중률, 목표 지연시간에 맞춰 커널과 전체 스택을 조정한다.
- 효과: 동일 모델이라도 목표 성능을 만족하면서 더 낮은 비용으로 서빙할 수 있다.
4.2. 함께 사용하는 최적화 기법
-
추측 디코딩(speculative decoding)
- 구조: 주 모델이 모든 토큰을 직접 계산하는 대신, 작은 초안 모델(draft model)이 다음 토큰 후보를 먼저 제안한다.
- 고객별 학습: Fireworks 플랫폼에서 파인튜닝과 비슷하게 데이터셋을 업로드해 자체 초안 모델을 학습할 수 있다.
- 효과: 초안 모델의 예측이 주 모델과 많이 맞으면 생성 속도가 빨라져 목표 지연시간을 맞추기 쉬워진다.
-
추가 최적화
- Disaggregation: 추론의 서로 다른 단계를 분리해 자원을 독립적으로 배분한다.
- Quantization: 가중치나 연산의 정밀도를 낮춰 메모리와 계산 비용을 줄인다.
- 통합 관점: 맞춤형 커널, 추측 디코딩, 분리형 처리, 양자화를 고객 워크로드에 맞춰 조합한다.
5. 세 가지 학습 경로
제품의 핵심은 모든 사용자가 같은 방식으로 학습하는 것이 아니라, 필요한 제어 수준에 맞는 경로를 선택하게 하는 데 있다.
5.1. Training Agent: 처음 학습하는 팀을 위한 경로
-
자연어에서 시작하는 설정
- 대상 사용자: 모델 학습 경험이 없는 제품 관리자와 빌더를 겨냥한다.
- 입력: UI에서 데이터셋 위치와 달성하려는 목표를 자연어로 입력한다.
- 계획 수립: 에이전트가 기반 모델을 선택하고 선택 이유, 하이퍼파라미터, 단계별 지도 파인튜닝(SFT) 계획을 제안한다.
-
검토 후 실행하는 흐름
- 승인 절차: 사용자가 모델·설정·학습 계획을 검토하고 승인한 뒤 실행한다.
- 기본 모델 사례: 시연에서는 Qwen3 8B를 기반 모델로 선택했다.
- 결과 보고: 정확도(accuracy), F1 score, 설정 요약, 다음에 시도할 만한 단계가 대시보드에 제시된다.
-
제약
- RFT 미지원: 시점상 training agent는 강화학습 기반 파인튜닝(RFT)을 지원하지 않았다.
- 실무적 영향: RFT가 “매우, 매우 인기 있는” 학습 방식인 만큼, RFT가 필요하면 관리형 학습이나 직접 API를 사용하는 다음 단계로 올라가야 한다.
5.2. Managed Training: 가장 널리 쓰이는 경로
-
간단한 실행 흐름
- 선택: 기반 모델을 고른다.
- 데이터 업로드: 학습 데이터셋을 올린다.
- 설정: 하이퍼파라미터를 정한다.
- 실행: Create를 클릭해 학습을 시작한다.
-
진행·품질 관찰
- 학습 대시보드: 학습 진행률과 에포크별 품질 변화를 확인할 수 있다.
- 손실 곡선: loss curve로 학습이 안정적으로 진행되는지, 과적합이나 개선 정체가 있는지 판단한다.
- 외부 지표 연동: API 키를 넣으면 Weights & Biases로 지표를 내보낼 수 있다.
-
배포
- 원클릭 배포: 학습이 끝난 체크포인트를 한 번의 클릭으로 호스팅한다.
- 프리셋: throughput, fast, minimal 템플릿 중 하나를 고른다.
- 트레이드오프: 프리셋은 처리량, 응답 속도, 첫 토큰까지의 시간(time to first token) 사이의 서로 다른 균형점을 겨냥한다.
5.3. Training API: 전문 ML 엔지니어를 위한 경로
-
사용자 정의 제어
- 대상 사용자: 자체 학습 루프와 손실 함수를 구현해야 하는 ML 엔지니어를 위한 고급 경로다.
- 가능한 작업: SFT, RFT, DPO를 포함한 학습 방식을 API로 조합하고 고객별 로직을 넣을 수 있다.
-
시연 범위
- 고객별 설정: 사용자마다 설정이 달라 일괄 시연하기 어렵기 때문에 Training API 자체는 데모하지 않았다.
- 참고 자료: Fireworks 웹사이트의 cookbook에서 API 기반 학습 루프를 확인할 수 있다.
-
세 학습 방식의 역할
- SFT(Supervised Fine-Tuning): 입력과 모범 답안 쌍을 사용해 모델이 원하는 응답 형식을 모방하도록 한다.
- RFT(Reinforcement Fine-Tuning): 평가 함수가 산출한 보상 신호를 기준으로 더 좋은 출력을 강화한다.
- DPO(Direct Preference Optimization): 선호 답변과 비선호 답변의 쌍을 이용해 사용자가 원하는 응답 방향을 직접 학습시킨다.
6. 학습-배포 데이터 플라이휠
특화 AI의 품질은 단일 학습 실행이 아니라 운영 데이터를 다음 학습으로 되돌리는 속도에서 누적된다.
6.1. 반복 구조
-
Train
- 자체 데이터와 적절한 학습 방식으로 오픈 모델을 조정한다.
- 체크포인트와 평가 지표를 저장해 다음 실험의 기준점을 만든다.
-
Deploy in one click
- 학습이 끝난 모델을 같은 플랫폼에서 즉시 엔드포인트로 배포한다.
- 배포 프리셋으로 처리량과 지연시간의 목표를 선택한다.
-
Monitor
- 토큰 처리량과 요청 패턴을 추적한다.
- 프롬프트 캐시 적중률과 추측 디코더의 효율을 확인한다.
- 품질 지표와 실제 사용자 피드백을 수집한다.
-
Retrain from checkpoint
- 실패 사례와 새 데이터를 다음 학습에 넣는다.
- 기존 체크포인트에서 재학습하며 데이터, 평가 함수, 하이퍼파라미터를 조정한다.
- 다시 배포해 이전보다 좋아졌는지 측정한다.
6.2. Hot loading으로 중단 없는 가중치 교체
-
문제
- 새 모델을 배포할 때 기존 엔드포인트를 내리고 교체하면 서비스 중단과 트래픽 전환 문제가 생긴다.
- 학습 루프가 자주 반복될수록 배포 중단 비용이 커진다.
-
해결
- Hot loading: 기존 엔드포인트를 유지한 채 새 체크포인트의 가중치를 뒤에서 교체한다.
- 제로 다운타임: 버튼 한 번으로 새 가중치를 활성화해 서비스 중단 없이 모델을 업데이트한다.
- 기원: Cursor가 모델을 학습·운영하는 과정에서 필요해 먼저 구축했고, 이후 일반 사용자에게 공개했다.
6.3. 수치적 충실도(numerical fidelity)
-
분리된 학습·서빙의 위험
- 부동소수점 차이: 한 클러스터에서 학습하고 다른 플랫폼에서 호스팅하면 가중치가 바뀌지 않아도 추론 중 부동소수점 연산이 달라질 수 있다.
- 재현성 저하: 학습 때 확인한 출력과 운영 때의 출력이 미묘하게 달라져 품질이 떨어지고, 원인을 찾기 어렵다.
-
같은 플랫폼이 필요한 이유
- 연산 일치: 학습과 서빙에서 같은 수치 처리 방식을 사용하면 학습된 모델의 동작을 운영 환경에서도 유지할 수 있다.
- 플라이휠 보호: 재학습할 때마다 플랫폼 차이로 품질이 흔들리면, 개선을 위한 반복이 오히려 불확실성을 만든다.
- 운영 기준: 학습 완료 후 배포 가능하다는 것만으로 충분하지 않고, 학습 시의 수치와 서빙 시의 수치를 맞추는 것이 중요하다.
7. 시연에서 확인되는 실무 흐름
7.1. Training Agent 시연
-
목표와 데이터 입력
- 사용자가 데이터셋의 위치와 원하는 업무 결과를 자연어로 설명한다.
- 별도의 저수준 분산 학습 설정 없이 모델 학습 작업을 시작할 수 있다.
-
에이전트의 제안
- Qwen3 8B를 기반 모델로 선택한다.
- 선택 근거와 하이퍼파라미터를 설명한다.
- SFT 단계, 평가 방법, 예상 결과를 포함한 계획을 세운다.
-
사람의 승인과 결과 확인
- 사용자가 계획을 승인하면 학습이 실행된다.
- 정확도와 F1 score를 확인하고 설정 요약을 검토한다.
- 결과에 따라 다음 학습이나 데이터 보강을 권고받는다.
7.2. Managed Training과 배포 시연
-
학습 시작
- 모델과 데이터셋을 선택하고 하이퍼파라미터를 지정한다.
- Create를 눌러 학습을 시작한다.
- 대시보드에서 진행률, 에포크별 품질, loss curve를 확인한다.
-
운영 연결
- 필요하면 Weights & Biases로 지표를 내보낸다.
- 학습된 체크포인트를 선택해 배포한다.
- throughput, fast, minimal 중 서비스 목표에 맞는 프리셋을 적용한다.
- 운영 중 hot loading과 모니터링을 사용해 다음 학습 사이클로 연결한다.
주요 발언 모음
“오픈 모델은 대부분 생산 환경에 준비되어 있다. GLM 5.2를 사용해 봤다면, 특히 코딩 유스케이스에서 그것이 사실임을 알 수 있다.”
“고객이 폐쇄형 모델에서 오픈 모델로 옮길 때 가장 큰 병목, 즉 격차는 품질이다.”
“오픈 모델이 폐쇄형 모델의 품질을 이기거나 맞추지 못한다면, 차별화 요소는 오픈 모델을 커스터마이즈하고 학습하고 개선해 폐쇄형 모델의 성능과 품질에 맞추는 방법에서 나온다.”
“한 플랫폼에서 학습하고 다른 플랫폼에서 호스팅하면 수치가 항상 호환되는 것은 아니다.”
“대부분의 고객과 사용자를 위한 AI 스택은 모델을 한 번 서빙하고 끝내는 방식에서, 같은 오픈 모델 자체를 학습부터 추론까지 개선하는 더 연속적인 루프로 이동하고 있다.”
핵심 데이터 & 수치
- 약 30조 토큰/일: GLM 5.2 출시 전 Fireworks가 처리한다고 제시한 일일 토큰 규모다.
- 10,000개 이상 기업: 플랫폼 사용 기업 수로 제시됐다.
- 약 200,000 RPS: 초당 처리 요청 수로 제시됐다.
- 하루 최소 5조 토큰 추가: GLM 5.2 출시 뒤 처리량 증가에 대한 추정치이며 측정 실적이 아니다.
- 3억 2,700만 달러: Series C 조달 규모다.
- 약 200명: 회사 인력 규모로 소개됐다.
- 13배: FireAttention으로 Cursor Composer 2의 추론 속도가 빨라졌다고 제시한 수치다.
- 40배: Vercel의 지연시간 개선 수치다.
- 12%: Genspark가 데이터 정제·평가 함수·RFT를 포함한 학습 루프를 적용한 뒤 얻은 품질 개선 수치다.
- Qwen3 8B: Training Agent 시연에서 선택한 기반 모델이다.
- SFT·RFT·DPO: 플랫폼에서 제공하는 대표적인 학습 방식이며, Training Agent의 시연 시점에는 RFT가 지원되지 않았다.
결론 및 시사점
- 폐쇄형 모델의 비용 상승은 오픈 모델로 이동할 충분한 이유지만, 전환을 결정하는 기준은 품질 유지 여부다.
- 최신 오픈 모델은 특히 코딩 영역에서 생산 환경에 들어갈 수준이므로, “오픈 모델은 연구용”이라는 가정은 더 이상 일반화하기 어렵다.
- 모델 선택보다 자체 데이터, 평가 함수, 하이퍼파라미터, 반복 학습을 묶는 커스터마이즈 역량이 품질 격차를 닫는 핵심이다.
- 팀의 숙련도에 따라 자연어 기반 Training Agent, 관리형 학습, 사용자 정의 Training API 중 하나를 선택하면 도입 장벽을 낮출 수 있다.
- RFT가 필요한지 먼저 판단해야 한다. Training Agent가 편리해도 RFT가 필요하면 관리형 경로 또는 API로 전환해야 한다.
- 추론 지연시간은 모델만의 속성이 아니다. 고객의 입력·출력 토큰, 캐시 적중률, 목표 지연시간에 맞춘 커널과 서빙 스택이 결과를 크게 바꿀 수 있다.
- 학습과 서빙을 서로 다른 플랫폼에서 수행하면 수치 연산 차이로 운영 품질이 흔들릴 수 있으므로, 수치적 충실도를 검증해야 한다.
- Hot loading은 새 체크포인트를 제로 다운타임으로 적용하게 해 학습 빈도를 높이고, 학습-배포 루프를 실제 운영에 연결한다.
- Fireworks가 제시한 13배·40배·12% 성과는 모두 회사 측 발표이며 독립 검증 수치가 아니다. 도입 전에는 동일한 데이터와 평가 조건으로 재현해야 한다.
- 장기적인 해자는 특정 기본 모델 자체보다 얼마나 빨리 학습하고, 배포하고, 측정하고, 다시 학습할 수 있는가에 있다. 오픈 모델은 타협안이 아니라 충분히 빠른 특화 루프를 갖춘 팀의 우위가 될 수 있다.