URL: https://www.youtube.com/watch?v=Fa3hQVIKShw
날짜: 2026-10-13
채널: aiDotEngineer
원제: Just-in-Time Ontologies: What Cheap Intelligence Means for Data — Hrishi Olickel, Southbridge AI
발표자: Hrishi Olickel (Southbridge AI)
📌 핵심 질문 / 이 영상이 다루는 핵심 논점
==데이터를 미리 하나의 보편적 스키마로 정규화하려는 발상은 실패할 수밖에 없으며, 실제 의사결정이 알려지는 순간에 값싼 지능으로 맥락을 조립하는 ‘즉시 생성하는 온톨로지(Just-in-Time Ontology)’가 더 유효하다.==
- 데이터에는 출처(Source), 저장(Storage), 의사결정(Decision), 모델의 사전 가정(Prior)이라는 서로 다른 네 가지 스키마가 있다.
- 데이터 변환은 단순한 포맷 변경이 아니라 기록 당시의 맥락과 지금 내려야 할 결정의 맥락을 합치는 판단(Discernment)이다.
- 모델을 설계자(Designer), 파이프라인 내부 작업자(Worker), 파이프라인을 개선하는 탐색자·힐 클라이머(Hill Climber/Surfer)로 분리하고, 비용·속도·정확도를 작은 검증 구간에서 함께 최적화해야 한다.
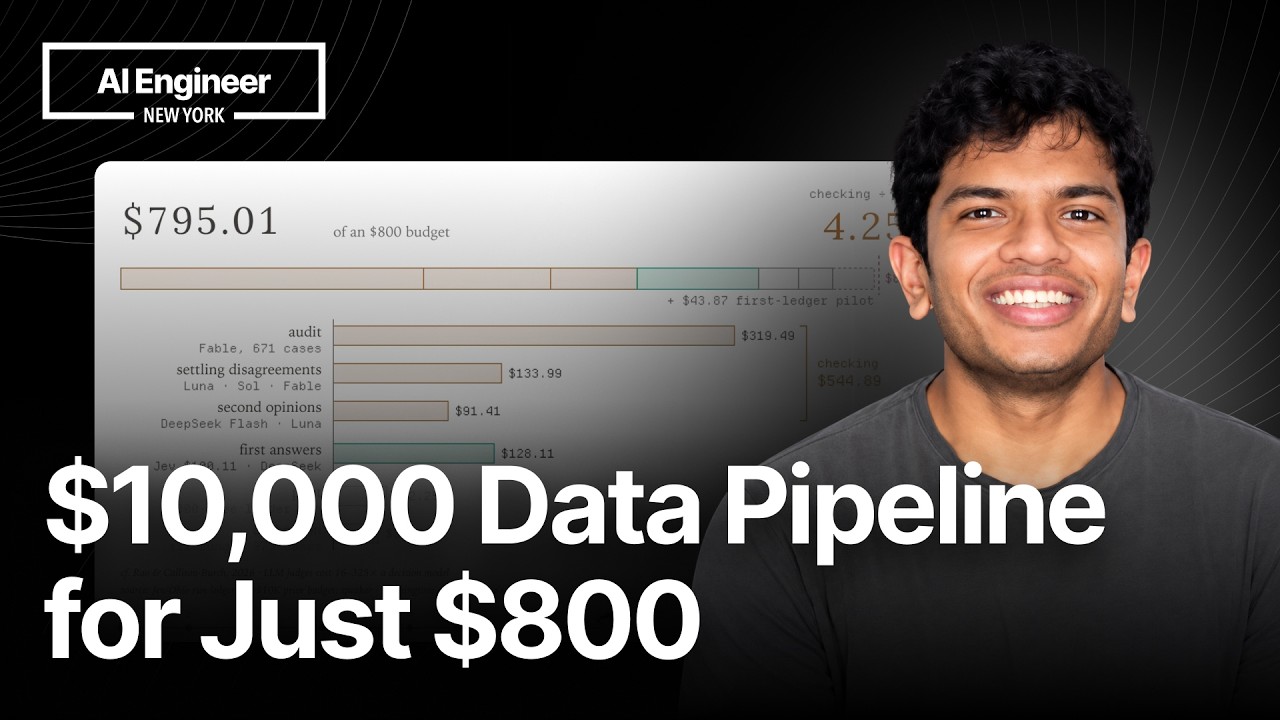
- 오하이오 캠페인 재정 데이터의 엔터티 해소(Entity Resolution) 사례는 약 1만 달러로 예상했던 작업을 7.95달러 규모로 수행하면서도, 23,317건 각각에 근거와 검증 범위를 남길 수 있음을 보여준다.
Hrishi Olickel은 지능이 데이터 변환의 마지막 병목이었다고 진단한다. 일반 지능과 판단을 필요할 때 호출할 수 있을 만큼 싸게 사용할 수 있게 되면, 데이터 파이프라인은 사람이 미리 고정한 하나의 정답 스키마를 적용하는 시스템이 아니라 질문이 생길 때마다 필요한 구조를 만들고 그 영수증(receipts)과 맥락을 보존하는 시스템이 된다. 다만 모델의 자신감만으로는 충분하지 않다. 안정적인 실행 표면, 실험의 예산 경계, 재사용 가능한 방법론, 명시적인 실패 표면이 있어야 값싼 지능이 안전하게 작동한다.
1. 변환 비용이 사라지는 시대와 ‘burrito surfing’
1.1. 컴퓨트와 스토리지의 가격 역전이 아키텍처를 바꾼다 (00:00~01:52)
-
도구는 시대의 능력을 늦게 따라간다
- Olickel은 DuckDB의 Hannis가 쓴 “분산 아키텍처가 컴퓨트와 스토리지가 느리고 비싸다는 전제 아래 10년을 허비한 것은 아닌가?”라는 문제 제기를 좋아한다고 말한다.
- 각 시대의 능력(Capability)이 아키텍처와 도구를 규정하지만, 도구는 계속 뒤늦게 따라온다.
- 컴퓨트가 스토리지보다 싸졌고, 그 컴퓨트를 누구나 쓸 수 있게 되었으며, 다시 더 빠르게 만들 때마다 아키텍처는 대규모로 바뀌었다.
-
현재 데이터 인프라의 낡은 전제
- 오늘날의 데이터 인프라는 변환(Transformation)이 비싸다는 가정 위에 세워져 있다.
- Olickel은 “변환이 더 이상 비싸지 않다면 어떨까?”라고 묻는다.
- 그가 보기에 변환의 마지막 병목은 일반 지능 또는 판단(General Intelligence/Judgment)이었다. 이제 그것을 필요할 때 호출하는 방식으로 쓸 수 있게 되었다.
-
burrito frontier와 burrito surfing
- ‘burrito frontier’는 모델·도구·비용의 현재 경계에서 빠르게 시도할 수 있는 영역을 가리키는 Olickel의 유머 섞인 표현이다.
- ‘burrito surfing’은 모델이 첫 해답에 멈추지 않고, 작업을 실행하고 디버깅하고 새 구조를 시험하면서 비용·속도·정확도의 더 좋은 지점으로 이동하는 과정을 뜻한다.
- 발표에서 다룰 네 축은 단일 온톨로지가 항상 실패하는 이유, 파이프라인에서 모델이 맡는 세 역할, 모델 사전 가정의 교집합을 이용하는 검증, 그리고 비용·속도·정확도를 동시에 조율하는 방법이다.
1.2. 오하이오 사례가 보여준 즉시 변환의 힘
-
문제와 초기 비용
- 새로운 모델 ‘Jeff’가 나왔을 때 Southbridge AI는 오하이오 캠페인 재정 기록에서 같은 기부자·회사·위원회인지 판별하는 엔터티 해소 파이프라인을 이미 운영하고 있었다.
- 당시 전체 작업 비용은 약 10,000달러로 예상됐다.
-
모델을 파이프라인에 삽입한 방식
- 시스템은 새 모델이 파이프라인의 어디에 맞는지 탐색했다.
- 12개가 넘는 접근법을 시험하고 통합했다.
- 첫 호출 뒤 10일 만에 오하이오에서 800달러 미만의 모든 기부자 사례에 대한 최종 정답(ground truth)을 확보했다.
- 이 결과가 Olickel이 말하는 ‘burrito surfing’과 ‘just-in-time transformation’의 힘이다.
2. 단일 보편 스키마가 실패하는 이유
2.1. 온톨로지는 기업용 마인드맵이지만, 하나로 고정할 수 없다 (01:52~04:28)
-
온톨로지에 대한 초기 믿음과 수정
- 온톨로지는 기업 버전의 마인드맵(mind map)이다.
- Olickel은 Southbridge를 창업한 2년 전에는 단일 보편 스키마를 이야기했다.
- 흔히 온톨로지와 마이그레이션이 실패하는 이유를 조직의 동의 부족(buy-in)과 중도 포기에서 찾는다. 사람들이 새 시스템으로 전환하지 않는다는 설명은 맞지만, 그것이 주된 이유는 아니다.
- 모든 정보를 눈 깜짝할 사이에 하나의 초대형 스키마로 통합할 수 있어도, 애초에 ‘초대형 스키마’라는 것이 존재하지 않는다는 문제는 남는다.
-
첫 번째 스키마: 출처 스키마(Source Schema)
- 정보가 실제로 어디에서 왔는지, 무엇에 접근할 수 있었는지가 출처 스키마다.
- 온도를 적는다고 하면 휴대전화는 지역 단위의 온도를 주고, 책상 위 센서는 덜 정확할 수 있지만 더 가까운 위치의 값을 주며, 시계도 또 다른 값을 준다.
- 요청을 끝까지 수행하려는 사람의 인내심도 출처 스키마에 포함된다. 어떤 정보가 존재하는지는 기기뿐 아니라 실제 측정과 기록이 실행되는 조건에 달려 있다.
-
두 번째 스키마: 저장 스키마(Storage Schema)
- 저장 매체에는 적을 수 있는 양과 정밀도에 한계가 있다.
- 측정 기기의 펌웨어 전체를 기록할 수 없고, 1초 안에 기록을 끝내야 한다면 시간을 초 단위까지 적을 수도 없다.
- 무엇을 버리고 무엇을 남길지 결정하는 제약이 저장 스키마다.
-
세 번째 스키마: 의사결정 스키마(Decision Schema)
- 같은 온도라도 무엇을 결정하려는지에 따라 필요한 기록이 달라진다.
- 사람의 쾌적함을 알아보려면 하루 동안 반복 측정하고 실제로 그 사람이 측정했는지 확인해야 한다.
- 날씨 지도를 만들려면 측정자가 누구인지는 중요하지 않지만, 정확한 위치·시각·사용 기기와 기기가 바뀌었는지가 중요하다.
- 민감한 장비를 설치할지 결정한다면 사람 자체의 영향이라는 변수를 제거해야 할 수 있다.
-
네 번째 스키마: 모델의 사전 가정(Prior Schema)
- 네 번째 스키마는 모델이 세상에 있어야 한다고 믿는 것을 작업에 가져오는 방식이며, 뒤에서 구체적인 오류 사례와 함께 설명된다.
- 출처·저장·의사결정·사전 가정의 네 스키마를 모두 동시에 알 수 있는 순간은 거의 없고, 대체로 의사결정이 내려지는 순간에야 필요한 조합이 드러난다.
2.2. ‘고객’은 질문에 따라 달라진다
-
기록 시점에는 사용처가 정해져 있지 않다
- 기업과 가정에서 기록되는 대부분의 데이터는 나중에 무엇에 쓰일지 알지 못한 채 저장된다.
- 모든 온톨로지의 첫 상자처럼 보이는 ‘고객’도 업무마다 다른 대상을 가리킨다.
-
부서별 고객 정의
- 청구(Billing)에서 고객은 돈을 지불하는 사람이다.
- 지원(Support)에서 고객은 전화를 거는 사람이다.
- 컴플라이언스(Compliance)에서 고객은 조직이 법적·규제적으로 책임져야 하는 사람이다.
- 환불할지, 계정에 더 많은 신용을 제공할지 같은 질문이 정해지는 순간에야 무엇을 어느 정도까지 알아야 하는지가 명확해진다.
-
즉시 생성하는 온톨로지의 정의
- 보편적 고객 개념은 존재하지 않는다. 답하려는 질문에서 분리된 고객 개념도 없다.
- 변환은 기록된 맥락과 의사결정의 맥락을 합쳐 정보를 실제로 쓸 수 있게 만드는 과정이다.
- 이 결합을 의사결정 공간이 알려지기 전에 미리 하는 것이 아니라, 결정 공간이 알려진 순간에 수행하는 것이 ‘just-in-time ontology’다.
- Olickel은 과거 직장에서 특정 숫자가 아예 존재하지 않도록 만드는 일이 자신의 업무 대부분이었던 이야기를 나중에 판단(Discernment)의 사례로 연결하겠다고 말한다.
3. 데이터 작업의 세 가지 실행 체계와 신뢰성
3.1. Southbridge가 지향하는 파이프라인 (05:14~07:34)
-
지능을 파이프라인에 심는다
- Southbridge의 구성원들은 자신들을 파이프라인에 지능을 삽입하는 ‘집착자(obsessives)’로 설명한다.
- 목표는 규모 있게 반복 실행되어 사람의 손에서 일을 완전히 덜어내고, 비용·성능·속도가 스스로 성숙하는 파이프라인이다.
-
현대 세계의 데이터 변환
- 벤치마크 설계와 추적, 코딩부터 보고 싶은 영화의 자막 제작까지 많은 작업을 메인 스레드에서 반복 가능한 시스템으로 옮겼다.
- 현대 세계에서 거의 모든 일은 데이터를 변환하거나, 데이터를 변환하기 어려운 정도에 의해 병목이 생긴다.
- 모든 경우의 공통된 임무는 결과를 사람들이 신뢰할 수 있게 만드는 것이다.
-
두 해 동안의 발전
- 초기에는 GPT-3.5 Turbo 수준의 모델을 의료, 노화(Aging), 광산 연구 같은 영역에서 신뢰성 있게 만드는 방법을 찾았다.
- 이후 데이터 작업을 위한 오픈소스 하네스(Harness)인 Hankwave를 만들고, 이를 이용해 모델들을 테라바이트 규모에서 함께 작동시켰다.
- 현재는 문제, 안전하게 실패할 방법, 작업 공간을 주면 모델이 해결책의 형태를 찾고, 맞는 모델을 선택하고, 파일럿을 실행하고, burrito surfing으로 가능한 최선의 선택을 찾는 시스템까지 만들었다.
3.2. 세 가지 데이터 workload regime
-
한 번 쓰고 한 번 실행하는 작업(Write Once, Run Once)
- 개발에서 거대한 즉시 실행 함수(Monster-scale Immediately Invoked Function)에 비유할 수 있다.
- 데이터셋 한 번 조인, 정보 마이닝, 단일 질문 답변처럼 한 번만 쓰고 작업이 끝나면 폐기한다.
-
많이 쓰고 한 번 실행하는 작업(Write Many, Run Once)
- 여러 크기의 작업물을 하나의 큰 공통 목표를 위해 만들고, 전체 목표를 한 번 수행한다.
- 오래된 시스템에서 수년 치 기록을 꺼내는 대규모 마이그레이션이 대표적이다.
- 각 작업물을 출처에서 개별 검증하고 다른 작업물과 대조한다. 전체 이동이 한 번만 일어나기 때문에 그때 확인해야 한다.
-
많이 쓰고 반복 실행하는 작업(Write Many, Run Many)
- 시간이 흐르며 새 정보를 계속 추가하는 반복 가능한 파이프라인이며, Southbridge의 주력이다.
- 파이프라인은 한 번 만들고 끝나는 코드가 아니라 유지보수되며, 반복 실행할수록 비용·속도·정확도가 성숙한다.
3.3. 데이터 기반 숫자의 위험과 에이전트의 과잉 응답
-
50명 사용자에게도 숫자를 만들려는 유혹
- Olickel의 이전 직장에서 가장 자주 들은 질문은 “이 결정을 데이터로 만들 수 있는가?”였다.
- 플랫폼에 선박이 수천 척일 때는 타당하지만, 사용자가 50명뿐일 때도 같은 질문을 던졌다.
- 50명으로 A/B 테스트를 하면 나쁜 생각인 이유는 결과를 얻지 못해서가 아니라, 오히려 결과를 얻게 되기 때문이다. 표본이 작은데도 숫자가 존재하면 그 숫자는 특정 결론을 주장하는 근거로 작동한다.
- 유일한 안전한 선택은 숫자를 아예 생산하지 않는 것이었다.
-
대화형 에이전트의 문제
- 오늘의 대화형 에이전트는 항상 답을 준다. 빠르게 변환을 수행하고 “물론입니다”라고 대답한다.
- 답이 존재하기만 하면 실수가 빠르게 누적된다.
- 채팅 안에서 그럴듯했던 순간이 프로덕션의 악몽이 되어 영원히 발견되지 않은 채 남을 수 있다.
4. 파이프라인에서 모델이 맡는 세 가지 역할
4.1. 설계자, 작업자, 탐색자 (08:30~10:34)
-
역할 1: 파이프라인을 설계하는 모델(Designer)
- 문제를 쪼개고, 초기 명세를 작성하고, 지출을 승인하고, 파이프라인의 형태를 정한다.
- 문서를 읽고 파이프라인이 어떻게 만들어지는지 이해하며, 시작 전에 결과를 예측해야 한다.
- 이 역할에는 더 느리고 더 많은 토큰을 사용해 깊게 생각하는 모델, 예를 들면 Opus급 모델이 적합하다.
-
역할 2: 파이프라인 안에서 일하는 모델(Worker)
- PDF를 읽고, 데이터베이스에 기록하고, 결과를 확인하는 실제 작업자다.
- 설계자와 달리 더 싸고 빠르며 전문화되어 있고 지시를 잘 따르며, 같은 일을 반복할 수 있고 결함을 예측할 수 있어야 한다.
- 설계 모델과 작업자 모델을 같은 컨텍스트 윈도우에 섞으면 서로 다른 최적화 방향을 망친다.
- 자연에서도 같은 층화가 보인다. 잎꾼개미(Leaf-cutter Ant) 군집은 작은·중간·큰·매우 큰 등 네 가지 크기의 작업자를 사용한다.
-
역할 3: 스스로 개선하는 모델(Hill Climber/Surfer)
- 첫 실행 결과를 기준으로 새 시도를 하고, 비용 예산을 조절하며, 빠르게 디버깅하고, 메모를 남기고, 정답뿐 아니라 최적의 해답까지 탐색한다.
- 이 모델에는 충분한 지식과 지시, 그리고 매우 안정적인 실행 표면이 필요하다.
- Olickel은 이 과정을 ‘burrito surfing’이라고 부르며 마지막 부분에서 구체적인 방법을 설명한다.
4.2. Jeff를 작업자로 배치한 이유
-
새로운 결정 모델의 위치
- Jeff와 같은 새롭게 부상한 결정 모델은 파이프라인을 설계하는 모델이 아니라 정보와 빠르게 접촉하도록 만들어진 작업자다.
- 따라서 대규모 workload의 가장 아래쪽에서 개별 질문을 처리하는 역할에 배치하기 쉽다.
-
모델 역할을 분리해야 하는 이유
- 설계자는 전체 구조와 앞으로의 성능을 예측해야 하므로 깊은 추론과 넓은 문맥이 필요하다.
- 작업자는 반복 가능하고 값싸며 빠른 처리가 중요하다.
- 탐색자는 두 결과를 비교하며 작은 구간에서 구조를 바꾸고, 검증된 개선을 파이프라인에 편입한다.
5. 오하이오 캠페인 재정 엔터티 해소의 전개
5.1. 작은 개발 세트에서 시작한 세 가지 구조 (10:39~12:18)
-
작업의 배경
- Jeff가 화요일에 출시됐을 때 Southbridge는 오하이오 캠페인 재정의 기부자를 처리하는 엔터티 해소 파이프라인을 깊이 개발 중이었다.
- 사람·회사·위원회가 같은 주체인지 판별하는 작업이며, 기존 결과의 한 화살표 뒤에 주 전체에 적용했을 때의 많은 설계 선택이 숨어 있었다.
-
초기 세 가지 아키텍처
- 작은 개발 세트에서 값싼 추론 모델 하나만 사용하는 구조를 시험했다.
- Jeff를 사용하고, Jeff가 확신하지 못할 때만 추론 모델을 호출하는 구조를 시험했다.
- 추론 모델이 답을 제안하고 Jeff가 약 200개의 보류(held-out) 가족 사례에서 검증하는 구조를 시험했다.
-
초기 결과와 질문 정의의 효과
- 값싼 추론 모델 단독은 Fable 수준의 성능을 약 2%의 비용으로 냈다.
- Jeff는 핵심 답을 처음에는 맞혔지만, 9개의 가구 연결(household legs)을 모두 자신 있게 ‘아니오’라고 하며 놓쳤다.
- 모델과 임계값은 건드리지 않고 질문을 다시 썼다. 가구 질문에 ‘충분한 증거로 간주되는 것이 무엇인지’를 명시하자 개발 세트의 13개 질문에 대해 Jeff는 전부 ‘아니오’에서 ‘예’로 바뀌었다.
- 이 사례는 모델 선택보다 정의와 질문 설계가 더 근본적인 오류 원인일 수 있음을 보여준다.
5.2. 주 전체 확대와 정의의 계층
-
반복되는 자격 검증(Qualification)
- 주 전체로 확대하면서 12회가 넘는 자격 검증 라운드를 수행했다.
- 각 라운드는 하나의 정의를 고쳤다.
- 무엇이 위원회(Committee)인지, 신고자(Filer)가 무엇을 의미하는지, 한 주소에 두 사람이 사는 것이 어떤 관계를 뜻하는지 등을 차례로 정의했다.
-
근거가 붙은 23,317건
- 오하이오의 23,317개 모든 사례에는 답이 무엇에 근거하는지와 어디까지 검증됐는지를 나타내는 레이블이 붙었다.
- 이 문제에 맞는 계층 구조를 발견했고, 단순한 최종 레이블이 아니라 근거와 검증 범위를 함께 저장했다.
-
비용 구조
- 주 전체 작업은 사전에 정한 800달러 예산 안에서 총 7.95달러에 끝났다.
- 첫 답변은 128회였고, 두 번째 의견·불일치 해결·감사에 해당하는 확인은 545회였다.
- 확인 단계가 첫 답변보다 약 네 배의 비용을 차지했지만, 신뢰성을 확보하는 핵심 지출이었다.
- Jeff 이전에는 약 10,000달러가 들 것으로 예상했으나, 파이프라인이 구축되고 검증된 뒤 다음 주의 감사 예산은 거의 0에 가까울 것으로 예상했다.
5.3. 10일간의 자동 탐색과 재사용 가능한 패턴
-
스스로 구조를 찾은 에이전트
- Astra에서 실행되고 이후 Opus에서도 실행된 4A 에이전트는 시스템을 만들고, 실행하고, 디버깅하고, 새 시도를 하는 과정을 반복하며 대부분의 접근법을 점진적으로 발견했다.
- 10일 동안 12개가 넘는 아키텍처를 시도했다.
- Hank 호출은 4,000회 이상, Jeff 호출은 90,000회였고, 당시 모델 생태계의 사실상 모든 선택지를 시험했다.
- 그 실행 내부의 모델들은 약 60억 토큰을 사용했다.
-
패턴 라이브러리에 기록
- 결과를 Southbridge의 에이전트 패턴(agentic patterns) 라이브러리에 다시 기록했다.
- 기존 패턴을 활용했고, 검증 편지(checking letter) 같은 새로 테스트된 패턴을 추가했다.
- 사람과 에이전트의 메인 스레드에서 작업을 떼어내는 가치가 여기에 있다. 모든 반복은 버전 관리되는 Hank 작업으로 남아 되돌리기 쉽고, 이해·디버깅·비평하기 쉬웠다.
6. 모델이 가져오는 사전 가정과 조용한 데이터 오류
6.1. 모델이 커져도 사전 가정은 사라지지 않는다 (13:49~15:41)
-
네 번째 스키마의 실체
- 모델은 사람처럼 세상에 무엇이 있어야 하는지에 대한 믿음과 사전 가정(Prior)을 모든 작업에 가져온다.
- 모델이 더 커지고 유능해져도 이 문제는 없어지지 않는다.
- 오히려 큰 모델은 자신의 믿음을 더 강하게 붙들고 더 격렬하게 주장하는 경우도 있다.
-
표기 차이로 사라진 데이터
- 한 파이프라인은
in_kind를 찾았지만 실제 파일에는 대문자 I와 하이픈이 들어간In-Kind형태가 있었다. - 모델은 15,658건의 현물 기부(in-kind contributions)를 일반 현금으로 세었다.
- 대출 상환(repayments)도 같은 방식으로 빠졌다.
- 문자열·열 이름의 작은 사전 가정이 거대한 집계 오류로 이어졌다.
- 한 파이프라인은
-
날짜 포맷 오류
- 다른 파이프라인은 파일이 사용하는 다섯 번째 날짜 형식을 시도하지 않고 네 가지 형식만 시도했다.
- 거래 날짜의 99.4%가 빈 값으로 나왔다.
- 그런데 행 개수와 달러 합계가 맞아 보였기 때문에 에이전트는 작업을 계속 진행했다.
- 결과가 ‘그럴듯하게’ 유지되는 구조가 오류를 발견하기 어렵게 만들었다.
-
음수 부호가 지워진 대출
- 여러 실행이 대출 금액이 음수라는 사실을 발견하고도, 그 부호가 중복 정보라고 판단했다.
- 절댓값을 저장하면서 순부채 784,000달러가 최종적으로 530만 달러의 부채로 변했다.
- 여러 모델이 이 결과를 함께 검증했기 때문에, 모델 수를 늘리는 것만으로는 잘못된 공통 가정을 고칠 수 없었다.
6.2. 인간 직관과 교차 모델 검증의 비용
-
인간이 발견하는 이유와 한계
- 캠페인 재정 지식을 아는 사람이라면 현물 기부가 사라진 것을 알아차리거나 확인해야 한다고 생각할 수 있다.
- 사람의 직관이 실제 발견의 계기였지만, 인간은 비싸고 느리고 일정이 멈추며 모델보다도 비결정적이고 방해받는 것을 싫어한다.
-
모델의 사전 가정을 교차시키기
- 인간의 사전 가정과 모델의 사전 가정을 교차시키는 대신, 서로 다른 모델 계열의 사전 가정을 교차시키면 검토 면적을 줄일 수 있다.
- 서로 다른 혈통(pedigree)의 모델은 같은 그룹의 모델보다 서로 다른 사전 가정을 갖고 더 자주 불일치한다.
- 단, 같은 회사에서 비슷한 방식으로 증류된 모델들은 예외가 될 수 있다.
-
Jeff와 Luna의 200개 보류 가족 사례
- Jeff와 Luna는 200개 중 194개에 동의했다.
- 그 194개의 공동 답변은 하나도 틀리지 않았다.
- 모든 오류는 두 모델이 불일치한 6개 가족 사례 안에 있었다.
- 따라서 전체를 똑같이 다시 검토하는 대신 불일치 영역에 검토 자원을 집중할 수 있다.
-
교차 모델도 만능은 아니다
- 한 벤치마크에서는 서로 다른 네 모델 계열이 모두 정답 키와 다른 부호 규칙을 공유해 같은 총합을 만들었다.
- 모델 계열이 다르다는 사실만으로 공통 세계관 오류가 제거되지는 않는다.
- 이런 지속적인 오류는 목록화하고, 발생 조건을 감시하고, 각각에 특화한 해결책을 적용해야 한다.
7. 자기 최적화를 가능하게 하는 네 가지 조건
7.1. 안정적인 배포 표면(Stable Deployment Surface) (16:42~18:14)
-
빠르게 변하는 런타임 위에 일관된 층을 둔다
- Southbridge는 Hank를 사용한다. Hank는 Claude Code와 Pi 같은 빠르게 움직이는 에이전트 런타임 위에 일관된 로그와 API 인터페이스를 제공하는 하네스다.
- 체크포인트, 롤백, 예산 집행을 기본으로 포함해 모델이 그 위에서 반복적으로 시도할 수 있게 한다.
- Olickel은 헤드리스 데이터 작업에서 Hankwave가 가장 오래되고 안정적이며 개방적인 선택이라고 평가한다.
-
두 번째 조건: 실험의 경계(Bounded Experiments)
- 비용·시간·접근 권한을 자원으로 통제할 수 있어야 실험할 수 있다.
- 상한이 없으면 모델이 좋은 아이디어를 내도 실험 비용과 실패 범위를 예측할 수 없다.
-
세 번째 조건: 노하우와 방법론(Knowhow and Methodology)
- 두 해 동안의 배포에서 얻은 에이전트 패턴, 디버깅 기법, 프롬프트 경험을 새 모델에 전달해야 한다.
- 적절한 추상화 계층을 사용하면 노하우를 토큰 효율적으로 표현할 수 있고 모델은 그것을 복잡한 문제에 구현할 수 있다.
-
네 번째 조건: 실패 표면(Failure Surface)
- 실패 표면은 무엇이 실패인지, 어느 기준을 넘으면 실패로 판정할지, 실패한 결과에 어떻게 대응할지를 미리 정의한 영역이다.
- “나에게 설 곳을 달라. 그러면 지구를 움직이겠다”는 고전적 비유처럼, 안정적인 스택과 실패에 대고 반복할 표면이 있으면 문제를 반복해서 해결할 수 있다.
- 네 조건 중 실패 표면을 말과 도구와 지시로 만드는 일이 가장 어려웠다.
- 최신 모델도 이 ‘지능의 불꽃’을 드문드문 보여줄 뿐이며, 안정적인 주변 구조 없이는 자기 최적화가 지속되지 않는다.
7.2. 실패 표면을 포함한 여섯 단계 실행 루프
-
1단계 — 작업을 명세하고 나누기(Spec and Split)
- Jeff 사례에서는 약 80만 행을 20만 개의 더 작고 전문화된 사례로 나눴다.
- 각 사례를 ‘어떤 종류의 기부자인가’처럼 유형이 지정된 질문으로 다시 쪼갰다.
-
2단계 — 실패 표면 결정하기
- 작은 데이터 조각에 좋은 모델을 돌리고, 그중 일부를 사람이 직접 확인해 기준선(baseline)을 만든다.
- 기준선보다 나빠지면 실패로 판정한다.
- 상황에 따라 자동 실패 시스템, 스키마 검사, 관찰 가능한 행동(behavior) 측정도 실패 표면으로 설정할 수 있다.
- 반드시 실행 전에 실패 표면을 정의해야 한다.
-
3단계 — 최소한의 제한 파일럿(Minimal Bounded Pilot)
- 제한된 비용·시간·권한 안에서 아키텍처를 시험한다.
- 처음부터 전체 데이터를 태우지 않고 작은 구간에서 결과가 기준선을 넘는지 확인한다.
-
4단계 — 검사를 rig와 codon으로 옮기기
- 어느 구조가 작동하기 시작하면 검사를 rig, 즉 제한된 작업 구간 사이에서 실행되는 코드로 옮긴다.
- 이런 독립적인 bounded work segment를 ‘codon’이라고 부른다.
- codon은 재사용하고, 독립적으로 반복하고, 검증한 뒤 순서대로 배치한다.
-
5단계 — 프로덕션 배포와 점진적 성숙
- 작동하는 파이프라인은 프로덕션에 배포한다.
- 한 번에 완벽한 구조를 선언하지 않고, 실제 반복 속에서 천천히 비용·속도·정확도를 성숙시킨다.
-
6단계 — 기준선에서 최적점으로 서핑하기
- 먼저 견고한 결과를 내는 아키텍처를 기준선으로 삼는다.
- 모델과 구성 요소를 더 빠르고 싼 것으로 교체한다.
- 알려진 중간 결과와 비교하고, 매번 성공 조건을 더 엄격하게 만든다.
- 복잡한 문제를 조각으로 나누면 각 조각이 자기 영역의 최적점으로 이동할 수 있고, 전체 비용·속도·정확도 전선(frontier)이 계속 앞으로 이동한다.
8. 즉시 생성하는 온톨로지의 최종 의미
8.1. 지능과 결과 사이의 재사용 가능한 중간물 (19:34~20:29)
-
온톨로지는 중간물이다
- Olickel은 Adam Smith를 빌려 “이런 시스템에서 온톨로지는 지능과 결과 사이의 중간물(intermediate)”이라고 설명한다.
- 중간물은 재사용하기 쉽다. 같은 질문을 다음 작업이 필요로 할 때 다시 활용할 수 있다.
-
생성 시점과 영수증
- 온톨로지는 작업이 필요할 때 만들어진다.
- 그 온톨로지와 함께 어떤 출처·저장 제약·결정 맥락·모델 가정으로 만들었는지 영수증(receipts)을 보존한다.
- 필요한 구조를 재사용하면 비용을 낮추고, 데이터셋 전체에 병렬로 실행해 규모를 키울 수 있다.
8.2. 보편적 온톨로지에 대한 사과와 낙관
-
결론은 ‘온톨로지가 없다’는 것
- Olickel은 “보편적인 온톨로지는 없다. 사실 한 번도 없었다”고 정리하며 자신의 초기 주장을 사과한다.
- 그렇다고 모든 스키마가 무효가 되는 것은 아니다.
- 주변 맥락을 레이블링하고 보존할 수 있다면 각각의 온톨로지와 스키마는 유효하다.
-
값싼 지능의 미래
- 값싼 지능이 세계 곳곳으로 스며들면 어떤 형식의 정보든 가능한 한 유용한 형태로 만들 수 있는 미래에 빠르게 가까워진다.
- Southbridge AI는 그 미래를 현실로 만들기 위해 일하고 있다는 말로 발표를 마친다.
주요 발언 모음
“우리 데이터 인프라는 변환이 비싸다는 생각 위에 세워져 있다. 변환이 더 이상 비싸지 않다면 어떨까?”
“나는 변환의 마지막 병목, 일반 지능 또는 판단을 해결했다고 믿는다.”
“보편적 스키마는 없다. 질문에서 분리된 고객이라는 개념도 없다.”
“의사결정 공간이 알려진 뒤에 스키마를 합치는 것, 그것이 내가 말하는 즉시 생성하는 온톨로지다.”
“모델은 자신이 세상에 있어야 한다고 믿는 것, 즉 사전 가정을 모든 작업에 가져온다.”
“숫자를 만들지 않는 것이 유일한 선택인 때가 있다. 숫자가 존재하는 순간 그 숫자는 결과를 주장하기 때문이다.”
“안정적인 스택과 실패 표면이 있다면, 아직 풀지 못한 제약도 반복을 통해 풀 수 있다.”
“온톨로지는 지능과 결과 사이에 있는 중간물이며, 재사용하기 쉽다.”
“보편적인 온톨로지는 없다. 하지만 맥락을 표시하고 보존할 수 있다면 모든 온톨로지와 스키마는 유효하다.”
핵심 데이터 & 수치
- 영상 길이: 21분 03초.
- 초기 예상 비용: 오하이오 캠페인 재정 엔터티 해소 전체 작업에 약 10,000달러.
- 초기 작업 기간: 새 모델을 처음 호출한 뒤 10일 만에 800달러 미만의 오하이오 기부자 사례에 대한 최종 ground truth 확보.
- 개발 세트 비교: 약 200개의 held-out 가족 사례에서 아키텍처를 비교.
- 비용 효율: 값싼 추론 모델 단독이 Fable 수준의 성능을 약 2% 비용으로 달성.
- 질문 정의 개선: Jeff가 개발 세트 13개 가구 질문에서 모두 ‘아니오’라고 답한 뒤, 충분한 증거의 정의를 명시하자 13개 모두 ‘예’로 전환.
- 주 전체 사례 수: 23,317건. 각 건에 답의 근거와 검증 범위를 표시.
- 실제 비용: 사전 800달러 예산 안에서 주 전체 작업 총 7.95달러.
- 호출 구성: 첫 답변 128회, 두 번째 의견·불일치 해결·감사 545회.
- 향후 비용: 검증된 파이프라인의 다음 주 감사 예산은 거의 0에 가까울 것으로 예상.
- 탐색 규모: 10일 동안 12개가 넘는 아키텍처, Hank 4,000회 이상, Jeff 90,000회, 약 60억 토큰.
- 누락 사례:
in_kind/In-Kind표기 차이로 15,658건의 현물 기부가 일반 현금으로 분류. - 날짜 오류: 다섯 번째 날짜 포맷을 놓쳐 거래 날짜 99.4%가 빈 값이었지만 행 수와 달러 합계는 맞아 보임.
- 금액 오류: 음수 대출 부호를 제거해 순부채 784,000달러가 530만 달러 부채로 변환.
- 교차 모델 결과: Jeff와 Luna가 200개 중 194개에 동의했고, 그 194개 공동 답변은 모두 정확했으며 오류는 불일치한 6개에 집중.
- 분할 규모: 약 80만 행을 약 20만 개의 전문화된 사례로 분할.
결론 및 시사점
- 데이터 플랫폼의 표준화 목표를 ‘하나의 영원한 스키마’가 아니라 ‘질문이 정해질 때 재현 가능한 맥락 조립’으로 바꿔야 한다.
- 출처·저장·의사결정·모델 사전 가정의 네 스키마를 분리해 기록하고, 최종 답과 함께 각각의 맥락을 보존해야 한다.
- 설계자 모델의 깊은 추론과 작업자 모델의 빠르고 싼 반복 실행을 같은 역할로 다루지 말아야 한다.
- 모델을 늘리는 것보다 질문 정의, 충분한 증거의 기준, 스키마 검사, 실패 조건을 먼저 명시하는 편이 효과적이다.
- 교차 모델 합의는 검토 범위를 줄이는 강력한 방법이지만, 공통된 부호 규칙이나 증류 계보가 만든 동일 오류를 별도로 탐지해야 한다.
- 전체 데이터에 곧바로 적용하지 말고, 사람이 일부 확인한 작은 기준선과 제한된 파일럿을 먼저 만들어야 한다.
- 성공한 검사를 codon과 rig로 캡슐화해 독립적으로 재사용하고, 버전 관리되는 작업으로 남겨야 한다.
- 자기 최적화의 전제는 안정적인 실행 표면, 비용·시간·권한의 경계, 재사용 가능한 방법론, 사전에 정의한 실패 표면이다.
- 값싼 지능은 데이터 변환 자체를 자동화하는 것이 아니라, 변환이 무엇을 의미하는지 결정하는 판단을 더 자주·싸게 실험하게 만든다.
- ‘온톨로지가 없다’는 결론은 포기의 말이 아니다. 맥락과 증거를 보존한다면 작업별 온톨로지를 만들고 다음 작업에서 재사용할 수 있다는 설계 원칙이다.
직접 서술형 20줄 핵심 요약
즉시 생성하는 온톨로지는 질문이 정해진 순간 데이터의 맥락을 조립하는 방식이다.
Hrishi Olickel은 값싼 일반 지능이 데이터 변환의 마지막 병목을 낮춘다고 주장한다.
데이터에는 출처 스키마, 저장 스키마, 의사결정 스키마, 모델 사전 가정이 함께 작동한다.
출처가 제공하는 정보와 저장 공간이 보존할 정보는 처음부터 다를 수 있다.
같은 온도도 쾌적함, 날씨 지도, 장비 설치라는 결정에 따라 필요한 맥락이 달라진다.
청구·지원·컴플라이언스의 고객 정의가 서로 다른 까닭은 질문과 책임이 다르기 때문이다.
오하이오 캠페인 재정 엔터티 해소는 Jeff와 여러 추론 모델을 결합해 주 전체로 확장됐다.
값싼 추론 모델은 Fable 수준의 성능을 약 2% 비용으로 냈다.
질문에 충분한 증거의 정의를 추가하자 Jeff의 개발 질문 13개가 모두 오답에서 정답으로 바뀌었다.
23,317건에는 답의 근거와 검증 범위를 나타내는 레이블이 남았다.
전체 작업 비용은 약 1만 달러 예상에서 800달러 예산 안의 7.95달러로 내려갔다.
10일간 12개가 넘는 아키텍처와 수천 회의 Hank 실행이 파이프라인을 다듬었다.
모델은 표기, 날짜 형식, 부호에 대한 사전 가정으로 조용하고 큰 데이터 오류를 만든다.
음수 대출을 절댓값으로 바꾸면 순부채 78만4천 달러가 530만 달러로 왜곡될 수 있다.
Jeff와 Luna의 합의 194건은 모두 맞았고, 오류는 불일치한 6건에 모였다.
서로 다른 모델도 같은 부호 규칙을 공유하면 똑같이 틀릴 수 있어 공통 가정을 별도 점검해야 한다.
자기 최적화에는 안정적인 실행 표면, 실험 경계, 방법론, 실패 표면이 필요하다.
80만 행을 전문화된 사례와 유형화된 질문으로 쪼개면 각 구간을 독립적으로 검증할 수 있다.
codon은 검증된 작업 구간을 재사용하게 하며 기준선에서 더 싸고 빠른 최적점으로 서핑하게 한다.
제목: 즉시 생성하는 온톨로지: 값싼 지능이 데이터 변환을 바꾸는 방식 | URL: https://www.youtube.com/watch?v=Fa3hQVIKShw | Obsidian: /Users/flowkater/Obsidian/flowkater/flowkater/Study/YouTube다이제스트/2026-10-13-aiDotEngineer-just-in-time-ontologies-cheap-intelligence-data.md