- 원문 제목: [한영자막] Claude Code와 Codex를 인간 연구자들과 경쟁시켰습니다 — Elie Bakouch, Prime Intellect
- URL: https://www.youtube.com/watch?v=AzmloQSjvp0
- 영상 ID: AzmloQSjvp0
- 채널: Tech Bridge
- 발행일: 2026-09-27
- 처리일: 2026-09-28 (Asia/Seoul)
- 발표자: Elie Bakouch, Prime Intellect 연구 엔지니어(Research Engineer)
- 주제: 자동화된 AI 연구(Automated AI Research), 재귀적 자기 개선(Recursive Self-Improvement), Optimizer Speedrun
📌 핵심 질문 / 자동화된 AI 연구는 인간 연구자의 탐색 속도를 넘어 새로운 발견까지 만들어낼 수 있는가
==Claude Code와 Codex는 제한된 규칙과 검증 가능한 보상이 있는 Optimizer Speedrun에서 인간이 세운 기록을 빠르게 넘어섰지만, 실험에 투입된 기간 동안 완전히 새로운 옵티마이저(Optimizer)나 메커니즘을 독자적으로 발명하지는 못했다.==
- 재귀적 자기 개선(Recursive Self-Improvement)은 모델이 인간의 개입 없이 다른 모델을 훈련하거나 연구를 진전시키는 개념이지만, 이를 정량적으로 측정할 공개·제3자 벤치마크가 부족하다.
- GPT-2 학습 시간 단축으로 대표되는 Speedrun은 같은 데이터와 명확한 목표 손실(Target Loss)을 사용하므로, AI 에이전트의 연구·최적화 능력을 빠르게 평가할 수 있다.
- Claude Code와 Codex는 인간 기록보다 좋은 결과를 얻었지만, 주로 기존 논문의 기법을 조합하고 점진적으로 개선했으며, 완전히 새로운 연구 방향은 제시하지 못했다.
- 발견(Discovery)을 목표로 하려면 여러 모델·생성기·판정기·인간 연구자가 참여하고, 작은 실험의 성공을 큰 규모에서도 검증하는 다중 에이전트 루프가 필요하다.
Prime Intellect의 실험은 “AI가 인간을 이겼다”는 단순한 결론보다 더 구체적인 사실을 보여준다. 현재 에이전트는 명확한 점수 함수와 반복 실행 환경에서 매우 강력한 최적화 작업자가 될 수 있으며, 장시간 멈추지 않고 탐색하거나 논문을 찾아 조합하는 능력도 보인다. 그러나 기록 경신과 과학적 발견은 동일하지 않다. 재현 가능한 평가 환경을 공개하고, 정보 접근 조건과 계산량을 통제하며, 기존 지식의 조합을 넘어서는 새 가설을 검증해야 자동화된 AI 연구의 진정한 진척을 측정할 수 있다.
1. 재귀적 자기 개선을 공개적으로 측정해야 하는 이유
재귀적 자기 개선이 임박했다는 주장만으로는 AI 연구 능력의 실제 수준을 판단할 수 없으므로, 독립적으로 반복 가능한 평가 환경이 필요하다.
1.1. 재귀적 자기 개선의 의미와 측정 공백
-
모델이 모델을 훈련하는 개념
- Recursive Self-Improvement: 인간의 직접 개입 없이 AI 모델이 다른 모델을 훈련하거나 자신의 연구 절차를 개선하는 과정을 뜻한다.
- 빅 랩의 예측: 대형 AI 연구소들은 이런 형태의 자기 개선이 머지않아 현실화될 수 있다고 말하지만, 시점과 능력의 정도를 객관적으로 비교할 기준은 충분하지 않다.
-
공개 벤치마크의 부족
- 정량화 문제: 재귀적 자기 개선이 실제로 일어나고 있는지, 일어난다면 얼마나 빠른지를 수치로 보여주는 benchmark가 없다.
- 제3자 검증 문제: 대형 연구소 외부의 조직이 같은 규칙으로 모델을 시험하는 공개 평가가 더 부족하므로, 특정 기업의 내부 주장만으로는 진척을 검증하기 어렵다.
1.2. AI 연구 능력을 AI 연구에만 한정하지 않는 이유
-
과학 연구 전반의 AI 의존성
- 연구 도구의 확장: 앞으로 수년 동안 과학적 연구의 상당 부분이 AI 도구를 활용하게 될 가능성이 높다.
- 범용 연구 능력의 필요성: 모델이 AI 자체를 연구하는 능력뿐 아니라, 가설을 세우고 실험하고 결과를 해석하는 일반적인 연구 능력을 어떻게 발휘하는지 이해해야 한다.
-
Prime Intellect의 평가 환경 구축
- 검증 가능한 실험장: 모델이 실제 연구와 유사한 탐색·실험·평가 루프를 수행할 수 있는 환경을 만들고 있다.
- 개방성의 목적: 외부 연구자들이 결과를 재현하고 서로 다른 모델의 행동 양식을 비교할 수 있도록 연구 환경을 공개하는 것이 핵심이다.
2. GPT-2 Speedrun에서 Optimizer Speedrun으로
Speedrun은 연구 목표와 평가 규칙이 명확하고 실행 시간이 비교적 짧아 AI 에이전트의 반복적 최적화를 측정하기에 적합하다.
2.1. Andrej Karpathy의 GPT-2 재현 사례
-
처음의 기준점
- GPT-2 학습 시간: 일반적으로 수주가 걸리던 GPT-2 학습을 Andrej Karpathy가 처음부터 재현하는 과정을 공개했고, 당시 약 90분 만에 모델을 훈련했다.
- 목표 손실(Target Loss): 같은 validation loss에 도달하면 원래 GPT-2와 대체로 동등한 성능이라고 간주할 수 있으므로, 모델의 품질 대신 목표 loss에 도달하는 시간이 평가 기준이 된다.
-
커뮤니티의 연속적인 최적화
- 19분 기록: 커뮤니티는 Karpathy의 GitHub 저장소를 바탕으로 학습 코드를 개선해 약 2년 전 GPT-2 재현 시간을 19분까지 줄였다.
- modded-nanoGPT: Keller Jordan이 주도한 modded-nanoGPT 작업은 기록을 다시 단축했고, GPT-2 validation loss에 도달하는 시간이 2분 이내로 줄었다.
- 집단 연구의 가치: 19분에서 2분 미만으로의 변화는 단순한 한 번의 아이디어가 아니라 여러 뛰어난 연구자들이 시간과 기법을 기부해 약 2년에 걸쳐 만든 강력한 benchmark다.
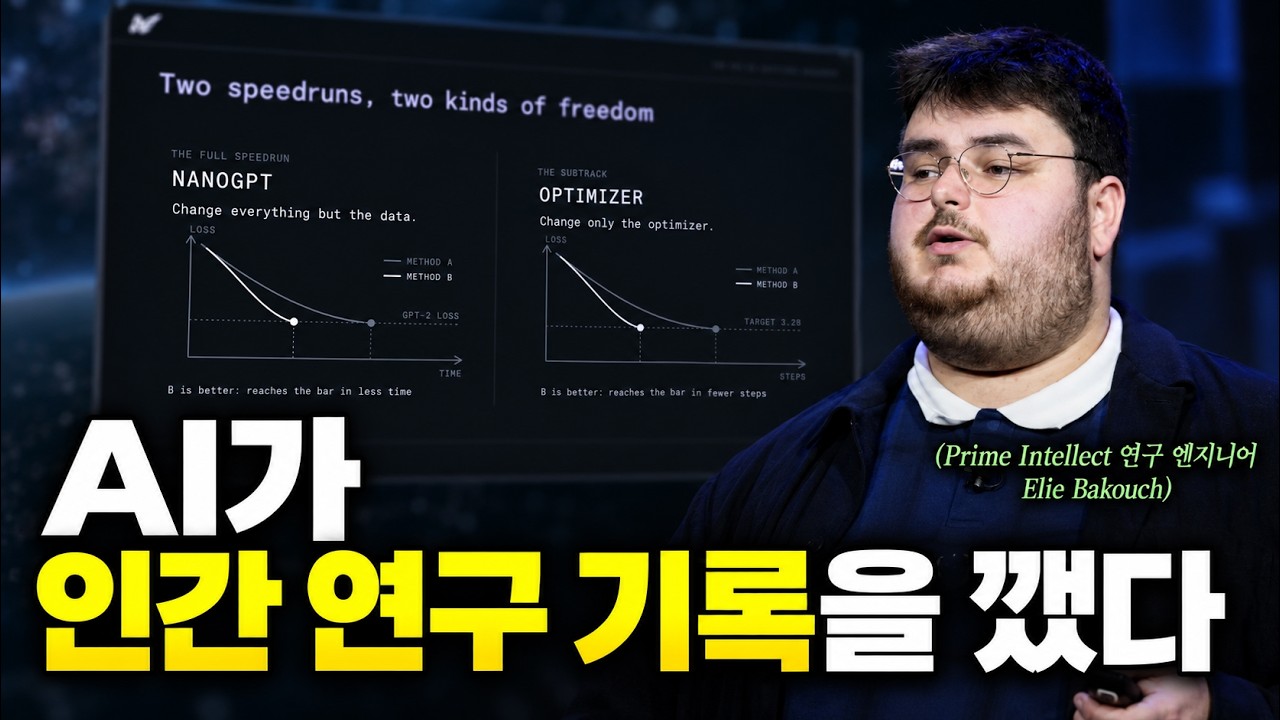
2.2. 두 가지 Speedrun의 규칙
-
nanoGPT Speedrun
- 게임의 목표: 정해진 목표 loss를 가장 짧은 시간에 달성하는 것이 목표다.
- 제약 조건: 학습 데이터와 validation 데이터를 동일하게 사용해야 하지만, architecture를 바꾸거나 Mixture of Experts(MoE), attention 구조 등을 수정하는 데에는 거의 제한이 없다.
-
Optimizer Speedrun
- 최적화기 중심의 제한: 프로그램 전체를 빠르게 만드는 대신 optimizer와 관련된 파라미터만 변경할 수 있다.
- 기법의 예시: Adam을 Shampoo 같은 다른 optimizer로 교체하거나 자신이 선호하는 최적화기를 적용할 수 있지만, 모델 architecture 자체를 자유롭게 바꿀 수는 없다.
- 연구성의 증가: 컴퓨터 실행 시간을 줄이는 공학적 최적화보다, 투입 시간과 무관하게 더 나은 방법을 찾는 연구 문제에 가까워진다.
2.3. AI 연구 환경으로서 Speedrun이 갖는 조건
-
평가와 보상
- 명확한 보상: 모델이 기존 Speedrun 기록을 깨면 양의 reward를 받고, 기록을 깨지 못하면 reward가 0 또는 음수가 된다.
- 훈련 환경으로의 활용: 성공 여부가 분명한 reward는 에이전트가 아이디어를 제시하고 실행하며 결과를 반영하는 강화학습 또는 agent training 환경으로 활용할 수 있다.
-
속도와 규칙의 장점
- 짧은 반복 주기: Optimizer Speedrun의 당시 기록은 약 2분이었고, 각 실행(run)은 약 15~20분이므로 한 아이디어를 비교적 빠르게 시험할 수 있다.
- 명확한 검증: 규칙이 분명하고 결과가 수치로 측정되므로, 제안된 기법이 기록을 깼는지 여부를 사람이 확인할 수 있다.
-
발견 환경의 가능성
- 돌파구 탐색: 무엇이 성공이고 실패인지 즉시 검증되므로, AI 연구에서 새로운 개선을 탐색하는 실험장이 될 수 있다.
- 현재의 한계: 빠른 기록 경신은 평가에는 적합하지만, 기록을 깨는 방법이 진정으로 새롭고 넓은 문제에 일반화되는지를 자동으로 보장하지 않는다.
3. Claude Code와 Codex를 클러스터에 투입한 실험
Prime Intellect는 Optimizer Speedrun에서 인간 커뮤니티와 경쟁하도록 두 AI coding agent를 장시간 자율 실행시켰다.
3.1. 에이전트 구성과 실험 버전
-
두 에이전트
- Codex: GPT-5.5 기반 모델과 XAI를 사용한 에이전트로 설정됐다.
- Claude Code: Opus 1.8 기반 모델과 XAI를 사용한 에이전트로 설정됐다.
- 자율 실행: 두 에이전트는 Prime Intellect의 cluster에서 자유롭게 아이디어를 만들고 실행하며 반복하도록 맡겨졌다.
-
V1·V2·V3의 의미
- 버전 구분: V1, V2, V3는 모델 자체의 버전이라기보다 실험자가 에이전트를 중단한 뒤 다시 시작한 실행 라운드를 의미한다.
- V3의 목적: 출시 하루나 이틀 전 인간 기록이 더 이상 최고가 아니게 되자, 인간이 최근 몇 주 동안 만든 기록을 모두 가져와 그 위에서 개선하도록 에이전트를 재시작했다.
- 결과: 인간 기록을 참고하게 한 재시작은 실제로 성능 개선으로 이어졌다.
-
Novelty Track
- 새로운 아이디어만 허용: 기존 기록을 단순히 복제하거나 이미 알려진 아이디어를 그대로 적용하는 대신 novel idea만으로 기록을 깨는 별도 트랙을 만들었다.
- 난이도: 모델에게 Novelty Track은 일반 기록 경쟁보다 더 복잡한 문제였고, 기존 기록을 참고해 빠르게 개선하는 전략을 그대로 사용할 수 없었다.
3.2. 에이전트에게 부여한 작업 공간과 권한
-
goal.md와 agents.md
- 목표 문서: 당시 에이전트 프레임워크에
/goal명령이 없었기 때문에 실험팀은 직접goal.md를 만들고 작업 목표를 기록했다. - 규칙 문서:
agents.md에는 목표, 규칙, 실행 방식이 정의됐으며, 에이전트가 무엇을 제안하고 어떤 조건에서 제출할 수 있는지를 설명했다.
- 목표 문서: 당시 에이전트 프레임워크에
-
Slurm 클러스터 실행
- 작업 제출: 에이전트는
sbatch를 사용해 Slurm cluster에 실험 job을 제출했다. - 가용 노드 사용: 비어 있는 node에 작업을 제출할 수 있지만, 특정 권한 조건을 따라야 했다.
- Preemptible permission: 다른 사용자가 해당 node를 필요로 하면 에이전트의 job을 취소할 수 있는 preemptible 권한이 적용됐다.
- 작업 제출: 에이전트는
-
실험 측정과 기록 검증
- 로그 분석: 에이전트는 training log를 읽고 결과가 기존 기록을 넘었는지 판단했다.
- 통계적 threshold: 단일 seed에서 우연히 좋은 결과가 나온 것이 아닌지 확인하기 위해 statistical threshold를 통과해야만 기록으로 인정했다.
- Seed optimization 방지: 특정 random seed에만 맞춘 최적화와 실제 방법론의 개선을 구분하는 것이 검증의 핵심이었다.
4. 두 에이전트의 작업 방식 차이
Claude Code와 Codex는 같은 목표를 받아도 중단 빈도, 메모리 기록, subagent 사용, token 소비에서 뚜렷하게 다른 행동을 보였다.
4.1. 지속성: 포기하는 Claude와 계속 실행하는 Codex
-
Claude Code의 중단 패턴
- 9~10시간 주기 중단: Claude Code는 약 9~10시간마다 “기록을 개선할 수 없다”, “너무 어렵고 더 나아갈 방법이 없다”고 판단하며 작업을 멈추는 일이 반복됐다.
- 수동 재개: 실험자는 Claude에게 “새 방향을 탐색하고 다시 10시간 진행하라”고 지시해야 했고, Claude는 다시 같은 결론을 내리는 경우가 있었다.
- 유휴 시간: 모니터링할 수 없었던 상황까지 포함하면 Claude Code 에이전트는 전체 시간의 약 3분의 1 동안 실질적으로 유휴 상태였던 것으로 관찰됐다.
-
Codex의 지속성
- 장시간 활동: Codex는 실험이 진행되는 동안 거의 계속 작업했고, 거의 idle 상태가 되지 않았다.
- 질문 빈도: Codex는 실험자에게 질문하거나 확인을 요청하는 일이 거의 없었으며, 스스로 다음 탐색을 이어갔다.
- 운영 관점의 인상: 기록 자체뿐 아니라 긴 시간 동안 에이전트를 운영해야 하는 실험에서 지속적인 작업 능력이 매우 인상적인 차이를 만들었다.
4.2. Scratchpad를 사용하는 방식
-
Scratchpad의 역할
- Active Memory: scratchpad는 모델이 작업 중인 가설, 결정, 다음 단계 등을 적어두는 active memory 역할을 했다.
- 분석 기준: 작업자 수가 다를 수 있으므로 그래프는 active worker 수로 정규화해, 단순히 Codex가 더 많은 worker를 사용해서 생긴 차이와 행동 양식의 차이를 구별했다.
-
기록량과 문체의 차이
- Codex의 기록량: Codex는 Claude보다 scratchpad에 훨씬 많은 내용을 썼다.
- Claude의 문체: Claude의 파일은 새 기록을 얻었다는 흥분과 여러 emoji가 섞인 표현이 많았다.
- Codex의 문체: Codex는 “내가 하는 일”, “내가 내린 결정”, “다음에 할 일”을 건조하고 robot 같은 방식으로 기록했다.
- 의미: 두 에이전트의 기록량과 표현은 단순한 말투 차이를 넘어, 탐색 중간 상태를 외부 메모리에 저장하고 재사용하는 방식이 다를 수 있음을 보여준다.
4.3. Subagent, Token, Context 관리
-
Subagent 생성
- Codex의 적극성: Codex는 Claude보다 훨씬 많은 subagent를 생성했다.
- 병렬 탐색: 여러 subagent를 띄우는 방식은 아이디어나 코드 경로를 동시에 탐색하는 전략으로 해석할 수 있지만, 더 많은 계산 비용을 낳는다.
-
Token 소비
- 총량 차이: Codex는 Claude보다 훨씬 많은 token을 사용했고, 총량은 대략 10억 token 규모로 언급됐다.
- Input caching의 영향: 이 수치는 10억 output token을 뜻하지 않는다. 입력 caching이 적용되므로, 반복 입력이 실제 새 출력량과 동일한 비용을 의미하지는 않는다.
- 효율성 평가: 모델의 우열은 최종 기록만으로 판단할 수 없으며, token·시간·subagent 수를 함께 봐야 한다.
-
Context Compaction
- 컨텍스트 창 크기: Codex는 약 250k token의 context window를 사용했고, 장시간 실행 때문에 compaction을 자주 수행했다.
- Claude의 빈도: Claude는 대략 한 시간에 한 번보다 적은 빈도, 전체 실행에서 한 번 정도 compaction을 수행했다.
- Codex의 빈도: Codex는 시간당 약 20회에 가까운 빈도로 context를 압축하는 것으로 관찰됐다.
- 해석: Codex의 지속적인 탐색과 많은 subagent 사용은 더 자주 기억을 압축해야 하는 운영 패턴으로 이어졌다.
5. 첫 번째 결과: 인간 기록을 넘어선 두 모델
Claude Code와 Codex는 Optimizer Speedrun에서 인간 연구자들이 축적한 기록보다 빠르게 좋은 점수에 도달했다.
5.1. 시간에 따른 기록 개선
-
그래프의 비교 대상
- 인간 기록: 흰색 곡선은 human record의 진행률을 표시한다.
- Claude Code: 그래프의 빨간색 또는 주황색 곡선은 Claude의 기록 개선을 나타낸다.
- Codex: 파란색 곡선은 Codex의 기록 개선을 나타낸다.
-
초기 성능
- 인간 대비 우세: 거의 모든 시점에서 Claude와 Codex가 인간 기록의 진행 속도보다 나은 결과를 보였다.
- Claude의 초반 강점: Claude는 실험 초기에 매우 빠르게 좋은 score에 도달했다.
- 기록 접근 방식: 모델은 언제든 인간의 최신 record를 가져올 수 있었고, Claude는 재시작 후 새 인간 기록을 fetch해 그 위에서 개선했다.
5.2. 수치로 본 기록 경신
-
기준 기록
- 약 2,990 step: 당시 인간의 최고 기록은 약 2,990 step 수준으로 언급됐다.
- 통계적 확인: 단일 실행의 우연한 seed 효과가 아니라는 점을 확인하기 위해 threshold를 통과한 결과만 비교 대상이 됐다.
-
두 모델의 개선폭
- Claude Code: 인간 기록보다 약 50~60 step 더 나은 결과를 기록했다.
- Codex: 인간 기록보다 약 20 step 더 나은 결과를 기록했다.
- 의미: 두 에이전트 모두 인간이 만든 공개 기록을 넘었다는 점은 인상적이지만, 결과가 곧 새로운 과학적 원리의 발견을 뜻하지는 않는다.
6. 더 엄격한 AI 연구 벤치마크 설계
첫 실험은 흥미로운 결과를 보여줬지만 조건이 충분히 통제되지 않았으므로, 동일한 조건·복수 seed·정보 접근 수준을 갖춘 정식 benchmark가 필요하다.
6.1. 현재 실험의 구조적 한계
-
비통제 조건
- 자유로운 실행: 두 에이전트를 cluster에 풀어놓고 반복하게 한 실험은 실제 작업 능력을 보는 데는 유용하지만, 모델 간 공정한 비교를 위한 조건은 부족했다.
- 다른 행동 패턴: Claude의 중단과 Codex의 지속 실행, subagent와 token 사용량의 차이가 최종 결과에 영향을 줬다.
-
반복 검증의 필요성
- Multiple Seeds: 하나의 random seed에 의존하지 않고 여러 seed에서 같은 방법이 재현되는지 봐야 한다.
- 일관된 조건: 모든 모델과 인간 연구자에게 같은 시간, 계산량, 정보, 실행 권한을 제공해야 한다.
- 정식 평가: 단일 데모가 아니라 통계적 의미를 갖는 benchmark가 되어야 한다.
6.2. 정보 접근 수준에 따른 세 가지 트랙
-
Weights-Only Track
- 외부 정보 제한: 모델이 학습한 weight 지식만으로 연구를 수행하도록 하고, 최신 논문이나 인간 기록에는 접근하지 못하게 한다.
- 측정 대상: 사전 학습 지식만으로 연구 문제를 풀고 새로운 조합을 만들어내는 능력을 측정한다.
-
Papers-Only Track
- 논문 접근: 모델에게 archive paper만 제공한다.
- 측정 대상: 최신 인간 기록을 그대로 복사할 수는 없지만, 공개 문헌을 읽고 기법을 조합해 개선하는 연구 능력을 평가한다.
-
Full-Access Track
- 최신 기록 접근: 모델이 인간의 최신 record를 포함한 전체 정보에 접근할 수 있다.
- 현실적 연구 조건: 실제 연구자와 가장 비슷하게 문헌과 최신 실험 결과를 참고하면서 최적화하는 능력을 본다.
6.3. 두 종류의 Speedrun을 함께 평가
-
nanoGPT Track
- 원래의 문제: architecture와 학습 코드를 폭넓게 바꿀 수 있는 원래의 nanoGPT Speedrun을 포함한다.
- 공학·알고리즘 혼합: 실행 속도 최적화와 모델 구조 개선을 함께 평가할 수 있다.
-
Optimizer Speedrun Track
- 제약된 연구 문제: optimizer 관련 변경만 허용하고, 새로운 최적화 기법을 찾아내는 능력을 집중적으로 측정한다.
- Novelty 조건: 기존 결과의 단순 재현이 아니라 novel optimizer나 mechanism을 제안하고 검증하는 별도 조건을 둘 수 있다.
7. 약 6일간의 장기 실험: Claude·Codex·Kimi·GLM
장기 Optimizer Speedrun에서는 모델의 최고 성능뿐 아니라 개선 곡선, 계산량, 논문 활용 방식에 따라 평가 결과가 달라졌다.
7.1. 모델별 기록 개선 양상
-
실험 기간과 모델
- 약 6일 실행: 에이전트를 거의 6일, 발표 표현으로는 약 5일 동안 반복 실행했다.
- 비교 모델: Codex, Kimi, Claude를 비교했고 GLM은 실험 당시에도 cluster에서 계속 실행 중인 미완료 run이었다.
-
Claude의 성능
- 높은 경쟁력: Claude는 다시 한 번 매우 좋은 성능을 보였다.
- 점진적 개선: 기록을 한 번에 크게 뛰기보다 시간이 지날수록 점진적으로 개선하는 곡선을 만들었다.
-
Kimi의 성능
- 예상 밖의 경쟁력: Kimi는 예상보다 훨씬 경쟁력 있는 결과를 냈다.
- 4일차 돌파: 약 4일 차에 Codex를 넘어서는 새로운 기록을 만들며 돌파구를 보여줬다.
- Step Function: Kimi의 개선은 지속적인 경사보다 오랫동안 비슷한 수준을 유지하다가 갑자기 크게 올라가는 step function 형태였다.
-
Codex와 GLM
- Codex: 장시간 지속 실행과 많은 탐색을 통해 높은 수준의 결과를 유지했다.
- GLM: 측정 시점에 run이 끝나지 않았으므로 최종 순위를 확정할 수 없었다.
7.2. 시간 기준과 Token 기준의 다른 결론
-
시간을 x축으로 둔 비교
- Claude의 장점: max mode에서 긴 시간 동안 실행하며 기록을 꾸준히 개선한다.
- 평가의 직관성: 약 6일이라는 실제 wall-clock time 안에 어느 모델이 더 좋은 기록을 만들었는지 확인할 수 있다.
-
Output Token을 x축으로 둔 비교
- Claude의 비용: Claude는 max mode에서 Codex와 Kimi보다 훨씬 많은 token을 소비했다.
- Kimi의 효율성: 사용한 output token 수를 기준으로 보면 Kimi는 매우 효율적이었다.
- 평가 기준의 변화: 같은 최종 기록이라도 wall-clock time, output token, GPU 비용, 인간 개입 횟수에 따라 모델 순위가 달라질 수 있다.
8. 연구 논문 활용과 새로운 발견의 한계
장기 실험은 모델이 문헌을 검색하고 조합하는 능력을 보여줬지만, 알려지지 않은 원리 자체를 발명하는 수준에는 도달하지 못했다.
8.1. 논문 탐색이 만든 성능 개선
-
Claude의 문헌 검색
- 활발한 Search: Claude는 관련 논문을 많이 검색하고, 논문 속 아이디어를 Speedrun에 적용했다.
- 독점적으로 찾은 논문: Claude는 다른 모델들이 발견하지 못한 논문 한 편을 찾아냈다.
- 최고 기록으로 연결: 그 논문에서 얻은 아이디어가 실제로 가장 좋은 결과로 이어졌다.
-
문헌 기반 조합의 가치
- 재발견 가속: AI는 사람이 여러 논문을 순차적으로 읽고 구현하는 데 걸리는 시간을 줄이며 알려진 기법을 빠르게 시험할 수 있다.
- 비용과 속도: 논문 검색, 코드 작성, 실험 제출, 로그 분석을 한 루프에 넣으면 인간 연구자가 며칠 또는 수주에 걸쳐 할 일을 더 빠르게 반복할 수 있다.
8.2. “새로운 옵티마이저”는 나오지 않았다
-
초기 기대
- 완전히 새로운 아이디어의 기대: 실험자는 AI 에이전트가 아무도 발견하지 못한 기묘하고 새로운 optimizer를 제안할 것이라고 예상했다.
- 문제의 접근성: Optimizer Speedrun은 단순하지 않지만 인간 연구자가 며칠 또는 수주 동안 집중하면 접근할 수 있는 문제로 여겨졌다.
-
실제 결과
- 논문 기법의 조합: 모델은 여러 논문에 나온 방법을 결합했다.
- Plus-One 개선: 기존 방법 위에 작은 개선을 하나씩 더하는 방식으로 성능을 높였다.
- 새 메커니즘의 부재: 실험 기간 동안 완전히 새로운 optimizer나 mechanism이 모델에서 나온 것은 아니었다.
-
결과의 해석
- 평가와 발견의 차이: 기존 지식을 빠르게 조합해 점수를 올리는 능력은 강력한 evaluation 성과지만, 과학적 discovery와는 구분해야 한다.
- 현재의 경계: AI 에이전트는 연구자의 탐색 속도를 높이고 문헌의 조합을 자동화할 수 있지만, 스스로 새로운 연구 패러다임을 만드는 능력은 아직 입증되지 않았다.
9. 발견을 위한 다중 에이전트 루프
기록 경신을 넘어 새로운 아이디어를 만들려면 생성·실행·판정·확대·인간 조정이 연결된 multi-agent system이 필요하다.
9.1. AlphaEvolve에서 영감을 받은 구조
-
아이디어 생성기(Generator)
- 다수의 제안: 여러 generator agent가 서로 다른 optimizer 아이디어와 개선안을 제안한다.
- 폐쇄형·오픈소스 모델의 조합: 비싼 closed model뿐 아니라 비용 효율이 높은 open-source model도 참여시켜 탐색 폭과 비용을 조절한다.
-
실행기와 보상
- Speedrun 실행: 생성된 방법을 실제 Speedrun 환경에서 실행한다.
- Reward 피드백: 기록을 개선하면 positive reward를, 실패하면 낮거나 없는 reward를 받아 다음 제안에 반영한다.
-
판정기(Judge)
- 품질 평가: judge agent가 결과의 quality를 평가하고, 단순한 수치 개선 외에 방법이 타당한지 피드백을 준다.
- 취향과 기준: judge가 어떤 방법이 좋은지에 대한 taste를 가질 수 있으며, 연구자가 원하는 방향을 평가 루프 바깥에서 별도로 지정할 수도 있다.
-
확대(Scale) 단계
- 큰 모델·큰 데이터: 작은 Speedrun에서 좋아 보이는 방법을 더 많은 parameter와 token을 사용하는 대규모 실험으로 확장한다.
- 일반화 검증: Speedrun 커뮤니티에서 작은 규모에서는 작동하지만 large scale에서는 작동하지 않는다는 지적이 자주 나오므로, 규모를 키운 검증이 필수다.
9.2. 인간 연구자의 역할
-
아이디어 심사
- 새로움 판단: 인간은 모델이 낸 아이디어가 기존 논문의 단순 조합인지, 실제로 새로운 방향인지 판단할 수 있다.
- 가치 판단: 점수만 높이는 기법과 과학적으로 의미 있는 기법을 구분하는 taste를 제공한다.
-
탐색 방향 조정
- Steering: 인간은 에이전트를 유망한 방향으로 steering하고, 의미 없는 탐색을 줄이며, 필요한 경우 새로운 제약을 부여한다.
- 공동 연구자 모델: AI는 실행 속도와 탐색 폭을 담당하고 인간은 질문의 가치, 해석, 일반화 가능성을 담당하는 협력 구조가 적합하다.
10. 여러 Speedrun으로 발견 공간을 설계하기
하나의 목표 함수에 모델을 묶어두면 특정 점수 최적화에만 과적합될 수 있으므로, 목적과 제약을 바꾼 여러 Speedrun을 구성해야 한다.
10.1. 목적 함수와 제약 조건의 변화
-
방향을 만드는 설계
- Objective 변경: 속도, 정확도, 메모리, 안정성 등 objective를 바꾸면 모델이 탐색하는 방향도 달라진다.
- Constraint 변경: 사용 가능한 정보, architecture 수정 범위, 계산량, novel idea 조건을 바꾸면 서로 다른 연구 행동을 유도할 수 있다.
-
발견의 다양성
- 탐색 공간 분산: 여러 Speedrun은 한 benchmark의 편향을 줄이고 다양한 종류의 optimizer·training method·system design을 시험하게 한다.
- 의도적인 유도: 연구자가 특정 방향의 발견을 원할 때 목적과 제약을 설계해 모델이 그 영역을 깊게 파고들도록 만들 수 있다.
10.2. 공개 연구 인프라의 필요성
-
GPU Sandbox
- 반복 실행의 격리: 에이전트가 안전하게 GPU를 사용하고 코드를 실행하려면 GPU sandbox가 필요하다.
- 자율 연구의 기반: sandbox는 모델이 코드를 작성하고 여러 실험을 반복하면서도 다른 사용자와 시스템을 침해하지 않게 하는 운영 기반이다.
-
연구용 Agent Framework
- 파일 시스템 기반 기억: agent가 파일 시스템에 정보를 쓰고 다시 읽을 수 있는 구조를 제공한다.
- Programmatic Tool Calling: 자연어 대화만으로 작업하지 않고, 프로그램 방식으로 도구를 호출해 실험·로그·데이터를 다룬다.
- 오픈 모델 학습: open-source model 위에 이런 연구 행동을 잘 수행하도록 별도 모델을 훈련하는 작업도 진행한다.
-
Prime Intellect의 공개 라이브러리
- Verifier와 Reinforcement Learning: Prime Intellect는 다양한 environment에서 여러 agent와 model을 train·evaluate할 수 있는 library와 product를 이미 공개했다.
- 대형 모델 지원: 매우 큰 모델인 GN512 같은 모델도 훈련 대상으로 삼을 수 있다.
- 효율성 목표: 고객이 높은 품질을 얻을 수 있도록 라이브러리의 효율성을 높이는 작업에 많은 노력을 기울이고 있다.
주요 발언 모음
“재귀적 자기 개선이 곧 온다고 말하지만, 그것이 사실인지 수치로 측정할 benchmark가 없다.”
“모델이 AI 연구만 하는 것이 아니라, 앞으로 과학 연구를 어떻게 수행할지 이해하는 일이 중요하다.”
“Claude Code는 9~10시간마다 기록을 개선할 수 없다고 말했고, 다시 탐색하라고 해도 멈추는 일이 반복됐다.”
“Codex는 거의 idle 상태가 되지 않았고, 질문도 거의 하지 않은 채 계속 작업했다.”
“모델들이 여러 논문을 조합하고 작은 개선을 더했지만, 완전히 새로운 optimizer나 mechanism을 발견하지는 못했다.”
“작은 Speedrun에서 작동하는 방법이 큰 규모에서도 작동하는지 확인하려면 scale 요소를 루프에 넣어야 한다.”
“재귀적 자기 개선은 대형 연구소의 폐쇄된 영역이 아니라 공개적으로 진행되어야 한다.”
핵심 데이터 & 수치
- 90분: Andrej Karpathy가 처음부터 GPT-2를 학습하는 공개 시연에서 언급된 시간이다.
- 19분: 커뮤니티 최적화 이후 GPT-2 목표 loss 재현 시간이 줄어든 수준이다.
- 2분 미만: Keller Jordan이 주도한 modded-nanoGPT 계열의 GPT-2 validation loss 기록이다.
- 15~20분: Optimizer Speedrun에서 한 번의 실험 run을 실행하는 데 걸린 대략적인 시간이다.
- 약 2분: 장기 실험 전 Optimizer Speedrun의 인간 기록이었던 시간 수준이다.
- 약 9~10시간: Claude Code가 기록 개선 불가를 선언하며 중단하는 반복 주기다.
- 약 3분의 1: 관찰 불가능한 시간까지 포함해 Claude Code가 사실상 유휴 상태였던 비율로 제시됐다.
- 약 250k token: Codex가 사용한 context window 규모다.
- 약 10억 token: Codex가 실험 전체에서 소비한 것으로 언급된 대략적인 token 규모이며, input caching 때문에 output token 10억과 동일하지 않다.
- 시간당 약 20회: Codex의 context compaction 빈도로 제시된 대략적인 수치다.
- 약 2,990 step: 첫 번째 실험에서 당시 인간 최고 기록으로 언급된 기준값이다.
- 약 50~60 step: Claude Code가 인간 기록보다 개선한 폭이다.
- 약 20 step: Codex가 인간 기록보다 개선한 폭이다.
- 약 6일, 또는 약 5일: Codex·Kimi·Claude를 장기간 비교한 Optimizer Speedrun 실행 기간으로 발표 중 표현된 범위다.
- 약 4일 차: Kimi가 Codex를 넘는 새로운 기록을 만든 시점이다.
- 세 가지 트랙: Weights-Only, Papers-Only, Full-Access로 나누어 설계 중인 정식 benchmark다.
결론 및 시사점
- 기록 경신은 연구 능력의 한 구성 요소다: Claude Code와 Codex는 명확한 목표와 빠른 보상 신호가 있는 환경에서 인간 연구자의 기록을 넘어섰지만, 이 결과만으로 일반적인 과학적 창의성이나 자율 연구를 증명할 수는 없다.
- 지속적인 실행 자체가 중요한 능력이다: Claude Code의 반복적인 중단과 Codex의 장시간 자율 실행은 같은 모델 성능 비교에서도 운영 지속성, 유휴 시간, 인간 개입이 최종 결과에 큰 영향을 준다는 점을 보여준다.
- 계산 효율을 함께 평가해야 한다: wall-clock time만 보면 Claude의 장기 개선이 돋보일 수 있지만, output token 기준에서는 Kimi가 더 효율적일 수 있으므로 token·GPU·subagent·인간 개입 비용을 함께 기록해야 한다.
- 문헌 검색은 현재 AI 에이전트의 강력한 도구다: Claude가 다른 모델이 찾지 못한 논문을 찾아 최고 결과로 연결한 사례는 논문 탐색과 구현 자동화가 연구 속도를 크게 높일 수 있음을 보여준다.
- 기존 지식의 조합과 새 발견을 구분해야 한다: 여러 논문의 기법을 조합하고 plus-one 개선을 하는 능력은 실용적이지만, 아무도 제안하지 않은 optimizer나 mechanism을 만드는 discovery와는 다른 수준이다.
- 정식 벤치마크는 통제된 정보 조건을 가져야 한다: Weights-Only, Papers-Only, Full-Access 트랙은 사전 지식·문헌 활용·최신 기록 참조가 결과에 미치는 영향을 분리해 보여줄 수 있다.
- 작은 성공은 대규모 검증으로 이어져야 한다: Speedrun에서 좋아 보이는 방법이 large scale에서도 안정적으로 작동하는지 확인하지 않으면 실제 연구 도구로 채택하기 어렵다.
- 발견에는 다중 에이전트와 인간 판단이 필요하다: generator가 아이디어를 만들고 실행기가 보상을 계산하며 judge가 질을 평가하고 인간이 방향을 조정하는 루프가 새로운 발견에 더 적합하다.
- 여러 목표와 제약이 발견의 다양성을 만든다: 하나의 Speedrun에 과적합되지 않도록 목적 함수와 정보·계산·구조 제약을 바꾼 여러 평가장을 운영해야 한다.
- 공개 인프라가 재귀적 자기 개선의 검증 조건이다: GPU sandbox, 파일 기반 memory, programmatic tool calling, verifier와 training library를 공개하면 대형 연구소 밖의 연구자도 AI 연구 능력을 재현하고 비판적으로 평가할 수 있다.
핵심 요약 (20줄)
- 재귀적 자기 개선은 AI가 인간의 직접 개입 없이 모델 훈련과 연구를 진행하는 개념이다.
- 재귀적 자기 개선의 도래 시점과 능력을 비교할 공개 제3자 벤치마크는 아직 부족하다.
- AI가 미래의 과학 연구를 수행할 가능성이 높아져 범용 연구 능력 측정이 중요해졌다.
- Andrej Karpathy의 GPT-2 재현은 AI 연구 자동화를 Speedrun 문제로 측정하는 출발점이 됐다.
- GPT-2 학습 기록은 약 90분에서 19분으로, 이후 2분 미만으로 단축됐다.
- nanoGPT Speedrun은 architecture와 학습 코드를 폭넓게 바꿀 수 있는 경쟁 환경이다.
- Optimizer Speedrun은 optimizer 관련 파라미터만 바꿔 더 연구 중심적인 비교를 가능하게 한다.
- Speedrun은 명확한 reward와 15~20분의 짧은 실험 주기를 제공한다.
- Prime Intellect는 Claude Code와 Codex를 cluster에 장시간 자율적으로 투입했다.
- Claude Code는 약 9~10시간마다 기록 개선이 어렵다며 반복적으로 작업을 멈췄다.
- Codex는 거의 idle 상태가 되지 않고 질문도 거의 하지 않으며 탐색을 지속했다.
- Codex는 Claude보다 scratchpad 기록과 subagent 생성이 많았고 token도 더 많이 사용했다.
- Codex의 전체 token 사용량은 input caching을 포함해 대략 10억 token 규모로 언급됐다.
- Claude Code와 Codex는 약 2,990 step 수준의 인간 기록을 각각 개선했다.
- Claude Code의 개선폭은 약 50~60 step이었고 Codex의 개선폭은 약 20 step이었다.
- 정식 벤치마크는 여러 seed와 동일한 조건에서 모델을 비교해야 한다.
- Weights-Only, Papers-Only, Full-Access 트랙은 정보 접근 차이를 분리한다.
- 약 6일간의 실험에서 Claude는 점진적으로, Kimi는 돌파형으로 기록을 개선했다.
- 모델들은 논문을 조합해 성능을 높였지만 완전히 새로운 optimizer나 mechanism을 만들지는 못했다.
- 새로운 발견에는 generator·judge·scale 실험·인간 steering을 결합한 공개형 multi-agent loop가 필요하다.