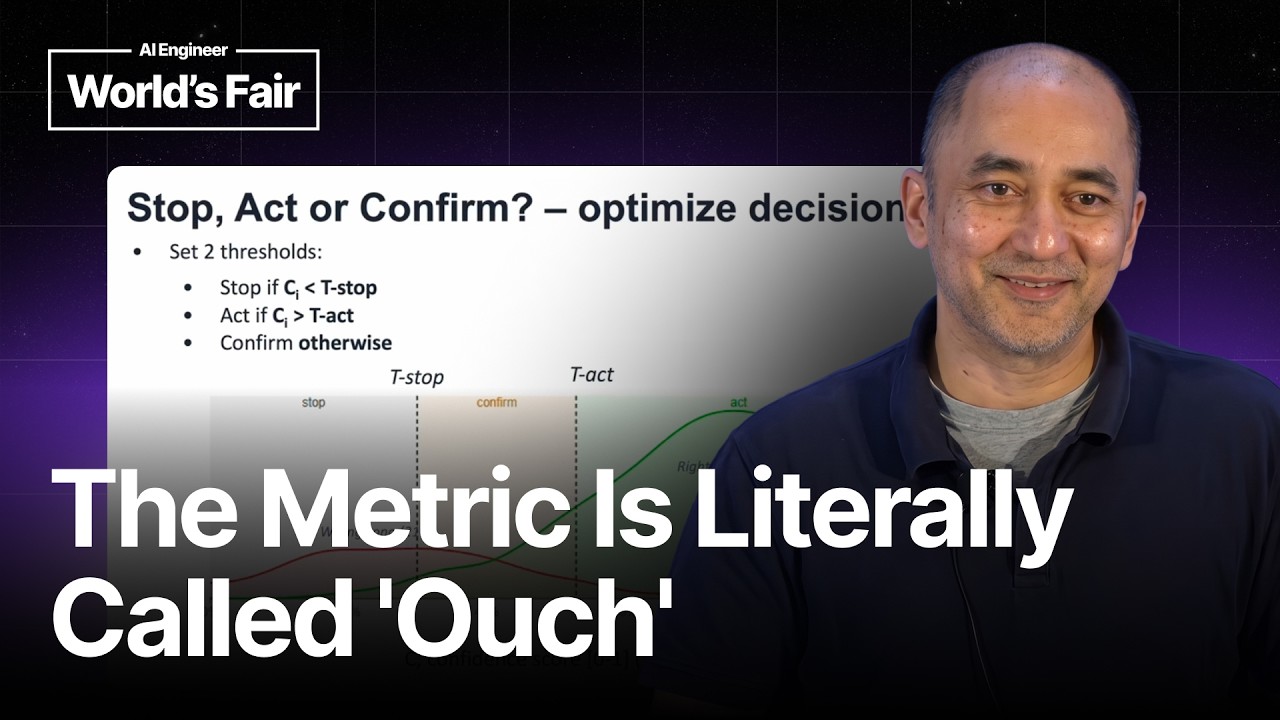
URL: https://www.youtube.com/watch?v=Zd5b40Jbp_k
날짜: 2026-09-16
채널: aiDotEngineer
원문 제목: Act, Confirm, or Stop? Smarter behavior for AI assistants, wearables & robots — Amit Desai, Roku
발표자: Amit Desai (Roku, 음성 AI 전문가)
영상 원본 게시일: 2026-09-15
영상 길이: 20분 24초
영상 ID: Zd5b40Jbp_k
메타데이터
source: YouTube / aiDotEngineercategory: ai-llmdrop_date: 2026-09-16slug: aidotengineer-act-confirm-or-stop-2026-09-16language: English → 한국어processing: 영어 자동 자막 기반, 문맥에 맞게 오인식 보정keywords: 음성 AI, 불확실성, 시스템 결정, confidence threshold, stop, confirm, embodied AI, user cost, OUCH heuristic, 멀티모달 인터페이스
📌 핵심 질문 / 이 영상이 다루는 핵심 논점
==AI 어시스턴트의 사용자 만족도는 인식 정확도만 높여서 개선되는 것이 아니라, 불확실할 때 행동·확인·중단 중 무엇을 선택할지 최적화함으로써 크게 개선될 수 있다.==
- 음성 인터페이스는 자연스럽고 강력하지만 오류가 계속 발생하며, 물리적·디지털 행동으로 이어질수록 오류의 비용이 커진다.
- 정확도(accuracy)는 시스템 품질을 조절하는 첫 번째 노브(knob)이고, 불확실성 속에서 어떤 대화 행동을 선택하는지는 별개의 두 번째 노브다.
- 사용자가 성공 상태로 돌아가는 데 걸리는 추가 시간으로 결과의 상대적 고통을 수치화하면, 임의의 임계값보다 나은 정책을 계산할 수 있다.
Amit Desai는 스마트 스피커가 노래를 잘못 재생하는 단순한 사례를 통해, 같은 79% 정확도를 유지하면서도 재생(act)만 하던 시스템을 재생·확인·중단 정책으로 바꾸면 사용자 관점의 비용을 낮출 수 있음을 보인다. 최적의 임계값은 직감으로 정하는 값이 아니라, 결과별 사용자 비용과 confidence score 분포를 함께 최적화해 정해야 한다. 이 원리는 TV 음성 어시스턴트, 웨어러블, 로봇, 이메일·전화 같은 디지털 행위까지 확장된다.
1. 발표자의 관점과 음성 인터페이스의 양면성
음성 AI의 자연스러움은 큰 장점이지만, 오류가 행동을 유발하는 환경에서는 정확도만으로 안전하고 만족스러운 경험을 만들 수 없다.
1.1. Amit Desai의 배경과 발표의 출발점
-
음성 AI 실무 경험
- 전문 분야: Amit Desai는 자신을 음성 분야의 subject matter expert라고 소개하며, 오랫동안 voice AI를 다뤘다고 말한다.
- 다양한 표면과 기기: Alexa와 Roku에서 일했고, 앱 스토어에서 직접 스타트업도 운영해 여러 디바이스 표면을 경험했다.
- 차별화된 관점: 음성 사용자 인터페이스(VUI)에 대한 깊은 전문성과 직관을 새로운 기술적 접근과 결합하면 마법 같은 경험을 만들 수 있다고 본다.
-
프런티어 기술에서 인간 인터페이스의 재정의
- 두 영역의 결합: 기존 VUI 감각과 새 기술을 함께 봐야 인간이 기계와 상호작용하는 방식이 바뀌는 현재의 프런티어 기술을 이해할 수 있다.
- 발표의 분위기: 발표자는 마지막 발표 순서라는 점을 언급하며 청중의 Patricia에게 인사한 뒤, 첫 슬라이드를 빠르게 지나 핵심 전제로 들어가겠다고 한다.
1.2. 음성의 힘과 고통
-
음성의 힘(power of voice)
- 자연스러운 인터페이스: 인간은 말하기를 좋아하고, 음성은 어디에서나 사용할 수 있는 가장 자연스러운 인터페이스다.
- 광범위한 적용성: 스피커, TV, 웨어러블 등 표면이 달라도 대화로 의도를 표현할 수 있다는 공통 장점이 있다.
-
음성의 고통(pain of voice)
- 오류 불가피성: 음성은 error-prone하며, 가까운 미래에도 오류는 계속 발생한다.
- 행동의 결과가 만드는 격차: 단순히 잘못된 답을 듣는 생성형 봇보다, 잘못된 물리적·디지털 행동을 하는 embodied AI가 훨씬 위험하다.
- 구체적 대비: 로봇이 시계를 쓰레기통에 버리는 오류는 노래를 잘못 재생하는 오류보다 훨씬 심각하다.
2. 정확도와 시스템 결정이라는 두 번째 노브
사용자 만족도를 높이는 방법은 인식 자체를 더 정확하게 만드는 것과, 같은 정확도에서 결과를 어떻게 처리할지 똑똑하게 선택하는 것으로 나뉜다.
2.1. 첫 번째 노브: 정확도 개선
-
스마트 스피커의 기본 문제
- 단순한 동작: 사용자가 노래를 요청하면 시스템은 곧바로 한 곡을 재생하고, 그 곡이 맞거나 틀린다.
- 측정 방법: 1,000개의 음성 요청에서 입력과 출력 결과를 관찰하고 사람이 정답 여부를 라벨링하면 시스템 성능을 측정할 수 있다.
-
79% 정확도의 분포
- 정답과 오답: 1,000개 중 790개(79%)는 요청한 노래를 재생하고, 약 210개(21%)는 다른 노래를 재생한다고 가정한다.
- 개선의 방향: 210개의 오류를 줄이기 위해 시스템 스택의 각 계층을 점진적으로 개선할 수 있다.
-
캐스케이드 시스템의 오류 지점
- 앞단 처리: wake word 계층과 음성 활동 감지(VAD)가 오류를 만들 수 있다.
- 언어 처리: 음성 인식(ASR), 의도 분류(intent classification), 엔터티 추출(entity extraction)도 오류에 기여한다.
- 한계: 계층별 정확도를 올리는 작업은 중요하지만, 이 접근만으로는 정확도가 완벽해지기 전까지 사용자가 잘못된 행동을 계속 감수해야 한다.
2.2. 두 번째 노브: 불확실성에서의 시스템 결정
-
정확도를 고정한 질문
- 문제의 재정의: 정확도를 79%로 그대로 두고도, 시스템이 불확실할 때 사용자 만족도를 높일 수 있는지 묻는다.
- 시스템 결정(system decision): 인식된 가설을 그대로 실행할지, 거부하고 멈출지를 선택하는 대화 행동을 정확도와 직교하는 별도의 조절 변수로 본다.
-
첫 번째 추가 행동, 중단(stop)
- 세 번째 선택지: 즉시 재생하는 기존 정책에
미안하지만 이해하지 못했다또는다시 말해 달라고 응답하고 아무것도 하지 않는 선택지를 추가한다. - 핵심 난점: 언제 멈출지를 정량적으로 결정해야 한다. 단순히 느낌이나 임의의 추측으로 정하면 더 나쁜 결과가 날 수 있다.
- 세 번째 선택지: 즉시 재생하는 기존 정책에
3. 중단 임계값과 OUCH 사용자 비용
confidence score를 사용자의 실제 손실과 연결하면, 중단할 지점을 직감이 아니라 비용 함수의 최소점으로 결정할 수 있다.
3.1. confidence score와 임계값
-
가설별 신뢰도
- 단순화한 모델: 각 요청에서 시스템이 만든 노래 가설 하나에 0과 1 사이의 confidence score가 있고, 이 점수가 합리적으로 보정되어 있다고 가정한다.
- 분포 시각화: 정답 790개와 오답 210개를 confidence score에 따라 x축에 배치한다. 실제 캐스케이드 시스템에서는 여러 계층의 점수가 있겠지만, 설명을 위해 하나로 합친다.
-
단일 임계값 t
- 중단 규칙: confidence
c < t이면 재생하지 않고 다시 말해 달라고 하며,c ≥ t이면 곡을 재생한다. - 직감의 함정: 65%처럼 그럴듯한 값을 임의로 고르면 합리적으로 보이지만, 중단과 오재생이라는 두 종류의 비용을 함께 고려하지 못한다.
- 중단 규칙: confidence
3.2. 두 종류의 나쁜 결과와 상대적 비용
-
중단의 비용
- 사용자는 원하는 노래를 듣고 싶어 하므로, 시스템이 멈추고 재요청을 요구하는 것 자체가 나쁜 결과다.
- 다만 사용자가 한 번 더 말하고 추가 지연을 기다리면 성공 상태로 돌아갈 수 있어, 보통 오재생보다 비용이 낮다.
-
오재생의 비용
- Prince와 Chris Brown 사례: 사용자가 Prince의
Kiss를 요청했는데 Chris Brown의Kiss가 재생되면, 사용자는 음악을 잠시 듣고 틀렸음을 알아차려야 한다. - 복구 노력: 사용자는 Alexa에게 들리도록 소리쳐 재생을 멈추고, 다시 요청해야 한다. 원하는 Prince의 곡으로 돌아가는 과정이 중단 후 재요청보다 훨씬 번거롭다.
- Prince와 Chris Brown 사례: 사용자가 Prince의
-
사용자 비용의 휴리스틱
- 측정 단위: 특정 결과가 발생한 뒤 사용자가 성공 상태로 돌아가는 데 필요한 추가 시간을 상대적 비용으로 사용한다.
- 가정한 값: 잘못된 노래 재생은 복구에 10초,
이해하지 못했다는 응답은 재발화와 추가 지연에 4초가 걸린다고 놓는다. - OUCH의 말장난: 결과별 사용자 비용 휴리스틱을
Outcome User Cost Heuristic으로 부르고, 앞글자를 따서 사용자의 고통을 뜻하는OUCH라고 명명한다.
3.3. 비용 함수로 임계값 최적화
-
비용 함수
- 임계값 t가 만드는 오재생 개수에 오재생 단위 비용 10을 곱하고, 중단 개수에 중단 단위 비용 4를 곱해 모두 더한다.
- 목표는 1,000건 전체에서 이 OUCH를 최소화하는 것이다. 결과별 비용을 단순한 오류 개수보다 더 정확히 반영한다.
-
단계별 결과
- 기존 재생 전용 정책: 210개의 오재생에 비용 10을 적용하면 총 2,100 OUCH, 요청당 2.1 OUCH다.
- 65%를 임의로 선택: 총 비용은 1,904, 요청당 약 1.9 OUCH로 내려가지만 최적점은 아니다.
- 43% 최적 임계값: confidence threshold를 43%로 계산하면 그래프의 최저점에서 총 비용이 약 1,270, 요청당 1.27 OUCH가 된다.
- 핵심 효과: 정확도는 여전히 79%로 동일하지만, 대화 행동과 비용 최적화만으로 사용자 관점의 경험을 크게 개선한다.
4. 확인(confirm)을 추가한 3중 행동 정책
중단과 실행 사이에 확인을 넣으면, 시스템은 확신이 중간인 경우 사용자의 짧은 판단을 받아 오류 비용을 더 줄일 수 있다.
4.1. 확인 행동의 의미
-
자연스러운 사람의 행동을 시스템에 반영
- 시스템은 요청을 들은 뒤
Kiss by Prince를 재생할까요?또는Kiss by Chris Brown을 재생할까요?처럼 해석 결과를 말하고 확인을 요청한다. - 사용자는 긍정해 실행하거나, 부정하고 원래 의도를 다시 말할 수 있다.
- 시스템은 요청을 들은 뒤
-
세 구간으로 분리되는 정책
- 낮은 confidence에서는 중단하고, 중간 confidence에서는 확인하며, 높은 confidence에서는 바로 실행한다.
- 두 개의 임계값
t1,t2가 confidence 분포를 stop·confirm·act 세 영역으로 나눈다.
4.2. 확인 결과별 상대적 고통
-
확인 자체의 비용
- 확인은 사용자의 흐름을 늦추므로 무료가 아니다.
- 하지만 잘못된 노래를 바로 재생하는 것보다 짧은 확인으로 예방하는 편이 이득일 수 있다.
-
긍정 확인과 부정 정정의 차이
- confirm yes: 사용자가
yeah라고 긍정만 하면 되므로 약 2초의 추가 시간이 든다고 가정한다. - confirm no: 사용자가 틀렸다고 말한 뒤 처음 원한 내용을 다시 말해야 하므로 약 6초의 비용을 둔다.
- 비대칭성:
yes와no는 같은 확인 결과가 아니며, 사용자가 다시 발화해야 하는 부정 정정이 훨씬 고통스럽다.
- confirm yes: 사용자가
-
확장된 OUCH 함수
- 중단·오재생·긍정 확인·부정 확인 각각의 발생 건수에 4·10·2·6의 단위 비용을 곱한다.
- 두 임계값의 모든 조합에서 합계를 계산하고, 가장 낮은 값을 만드는
t1,t2를 선택한다.
4.3. 2차원 최적화 결과
-
히트맵과 최적 임계값
- 하나의 t를 고르는 문제가 두 개의 임계값을 고르는 2차원 문제가 되므로, 비용을 히트맵으로 표시할 수 있다.
- 가정한 비용과 confidence 분포에서는
t1=41%,t2=49%가 최적점이다.
-
결과의 민감도
- 이 정책을 적용하면 총 비용은 약 1,464, 요청당 약 1.46 OUCH 수준으로 내려간다.
- 오재생이 훨씬 더 짜증나고 복구에 오래 걸려 단위 비용을 20으로 바꾸면 최적 임계값과 비용도 달라진다.
- 따라서 숫자는 보편적 상수가 아니라 실제 사용자 연구, 표면별 지연, 결과의 위험도를 반영해 학습·갱신해야 하는 휴리스틱이다.
5. 실제 시스템과 다른 디바이스 표면으로의 확장
오프라인 그래프는 원리를 설명하는 단순화이고, 실제 제품은 실시간으로 사용자·상황·표면을 반영해 결정해야 한다.
5.1. 단순 예시에서 학습된 실시간 모델로
-
개선의 누적
- 재생만 하는 나이브한 정책은 요청당 2.1 OUCH다.
- 임의의 중단을 넣으면 1.9, 비용을 최적화한 중단을 넣으면 1.27, 확인까지 추가하고 최적화하면 약 1.26~1.46 수준으로 내려간다.
- 각 단계는 정확도를 바꾸지 않고 행동 레이어와 사용자 결과 비용을 정교하게 만든다.
-
현실적인 구현
- 실제 제품에서 고정된 오프라인 임계값 하나나 두 개를 그대로 쓰지는 않는다.
- 사용자 발화, confidence, 맥락, 디바이스 표면, 과거 반응을 입력으로 받아 실시간으로 행동을 선택하는 학습된 결정 모델이 필요하다.
- 핵심 원칙은 동일하다. 각 가능한 행동의 결과를 사용자 비용으로 환산하고, 기대 OUCH가 가장 낮은 행동을 고른다.
5.2. TV 음성 어시스턴트 사례
-
공통으로 유지되는 요소
- TV에서도
채널을 열어 달라는 의도는 흔한 음성 요청이며, confidence에 따라 중단·확인·실행을 나누는 접근을 그대로 적용할 수 있다. - 음성 명령이 틀렸을 때 사용자가 성공 상태로 복귀하는 비용을 계산하는 기본 구조는 스마트 스피커와 같다.
- TV에서도
-
멀티모달 UI가 바꾸는 비용
- 시각적 확인:
ABC News Live를 말한 것인가요?라고 음성으로만 묻는 대신 화면에 여러 선택지를 표시할 수 있다. - 입력 방식: 사용자가 리모컨으로 원하는 항목을 고르면 말로
yes또는no를 답하는 것보다 고통이 낮으므로 confirm 비용을 낮게 책정한다. - 잘못된 실행의 위험: 채널을 실행하면 현재 시청 상태에서 이탈할 수 있다. 현재 상태를 잃는다면 오재생 또는 오실행 비용은 훨씬 높아질 수 있다.
- 변경되는 값: 같은 원리가 적용되더라도 화면 존재 여부, 입력 방식, 현재 상태, 복구 난이도에 따라 비용과 최적 임계값은 달라진다.
- 시각적 확인:
5.3. 웨어러블·로봇·디지털 행동
-
행동의 물리적 확장
- 웨어러블과 로봇은 음성 해석이 곧 기기 제어와 물리적 행동으로 이어질 수 있다.
- 시계를 버리거나 물건을 이동시키는 오작동은 잘못된 음악처럼 즉시 되돌릴 수 없는 손실을 만들 수 있다.
-
디지털 행동도 같은 문제를 가짐
- 전화 걸기, 이메일 보내기처럼 겉으로는 물리적이지 않은 행동도 잘못 실행되면 취소·정정·관계 회복의 비용이 크다.
- 정확도가 높아질수록 시스템이 더 많은 행동을 자동화하게 되므로, 남은 불확실성을 행동 정책으로 관리해야 한다.
주요 발언 모음
“음성은 작동할 때는 훌륭하지만, 작동하지 않을 때는 나쁘다.”
“사용자 만족도를 높이는 노브는 정확도만이 아니다. 우리가 충분히 사용하지 않는 두 번째 노브, 시스템 결정이 있다.”
“잘못된 노래를 재생하는 것은 ‘이해하지 못했다’고 말하는 것보다 사용자 비용이 훨씬 크다.”
“정확도를 전혀 바꾸지 않고도, 영리한 시스템 행동과 OUCH 비용 최적화로 더 만족스러운 어시스턴트를 만들 수 있다.”
“이 발표에서 한 단어 또는 두 단어만 기억한다면 경험의 OUCH를 최소화하라.”
핵심 데이터 & 수치
- 기본 정확도: 1,000건 중 790건 정답, 210건 오답으로 79% 정확도를 가정한다.
- 오류 계층: wake word, VAD, ASR, 의도 분류, 엔터티 추출 등 캐스케이드 스택의 여러 계층이 오류에 기여한다.
- 중단 비용: 다시 말하기와 추가 지연에 4초를 가정한다.
- 오재생 비용: 잘못된 곡을 멈추고 다시 요청해 성공하기까지 10초를 가정한다.
- 단일 임계값: 65%를 임의로 택하면 총 1,904 OUCH(요청당 약 1.9), 비용 최적화된 43%에서는 총 약 1,270 OUCH(요청당 1.27)다.
- 확인 비용: 긍정 확인은 2초, 부정 후 재진술은 6초를 가정한다.
- 3중 정책: 오재생 비용 10, 중단 4, 긍정 확인 2, 부정 확인 6의 조합에서
t1=41%,t2=49%가 최적이며 총 비용은 약 1,464다. - 민감도: 오재생 비용을 20으로 바꾸면 최적점도 바뀐다. 비용은 제품 표면과 사용자 연구에 맞게 재추정해야 한다.
결론 및 시사점
- 음성 AI 품질을 정확도 하나로만 평가하면 실제 사용자가 겪는 복구 노력과 위험을 놓친다.
- confidence가 낮을 때 중단하고, 중간일 때 확인하며, 높을 때 실행하는 정책은 정확도와 별개의 품질 레이어다.
Outcome User Cost Heuristic(OUCH)처럼 결과별 복구 시간·노력·위험을 비용으로 모델링하면 행동 임계값을 데이터로 선택할 수 있다.yes확인과no정정, 화면 선택과 리모컨 입력처럼 사용자 경험의 세부 경로는 모두 서로 다른 비용을 가진다.- 스마트 스피커에서 검증한 원리를 TV, 웨어러블, 로봇, 전화·이메일 자동화로 확장하되, 각 표면의 멀티모달성·가역성·현재 상태를 비용에 반영해야 한다.
- 실제 제품에서는 고정 임계값보다 맥락과 사용자 반응을 학습하는 실시간 결정 모델이 적합하다.
- embodied AI가 물리적·디지털 행동을 맡게 될수록 정확도만 높이는 전략은 병목이 되며, 불확실성 속에서의 대화 행동 설계가 필수다.
- 최종 목표는 시스템이 얼마나 자주 맞혔는지만이 아니라 사용자가 성공 상태로 돌아가기까지 겪는 OUCH를 최소화하는 것이다.
핵심 요약 (20줄)
-
음성은 인간에게 가장 자연스러운 인터페이스지만 인식 오류가 계속 발생한다.
-
음성 오류의 비용은 답변을 틀리는 수준에서 물리적·디지털 행동을 잘못하는 수준으로 커지고 있다.
-
Amit Desai는 Alexa, Roku, 스타트업에서 쌓은 음성 AI 경험을 바탕으로 행동 설계의 필요성을 제안한다.
-
음성 AI 사용자 만족도에는 정확도 개선과 시스템 결정이라는 두 개의 독립적인 조절 노브가 있다.
-
스마트 스피커가 1,000개 요청 중 790개를 맞히면 기본 정확도는 79%이고 210개는 오답이다.
-
wake word, VAD, ASR, 의도 분류, 엔터티 추출 등 여러 계층이 음성 AI 오류에 기여한다.
-
정확도를 그대로 두어도 confidence에 따라 재생하거나 중단하는 정책을 추가할 수 있다.
-
낮은 confidence에서 재생을 거부하고 다시 말해 달라고 하면 오재생 일부를 예방할 수 있다.
-
Prince의 ‘Kiss’ 대신 Chris Brown의 곡을 재생하면 사용자가 멈추고 다시 요청해야 한다.
-
오재생 복구에는 약 10초, 이해 실패 후 재발화에는 약 4초의 사용자 비용을 가정한다.
-
결과별 사용자 비용을 합산하는 Outcome User Cost Heuristic을 OUCH라고 부른다.
-
모든 요청을 재생하는 정책의 비용은 요청당 2.1 OUCH이고 65% 중단 임계값은 약 1.9다.
-
비용 함수를 최적화하면 43% 임계값에서 요청당 약 1.27 OUCH까지 낮아진다.
-
확인 행동은 시스템이 해석 결과를 말한 뒤 사용자의 긍정이나 정정을 받는 중간 선택지다.
-
긍정 확인에는 약 2초, 부정 후 의도 재진술에는 약 6초의 비용을 배정한다.
-
stop·confirm·act 세 영역을 나누는 최적 임계값은 가정한 분포에서 41%와 49%다.
-
비용 숫자는 오재생의 위험도와 디바이스 표면의 복구 난이도에 따라 달라진다.
-
TV에서는 화면과 리모컨이 확인을 대신하므로 음성 확인보다 비용이 낮아질 수 있다.
-
웨어러블, 로봇, 전화, 이메일은 오작동의 물리적·사회적 손실 때문에 더 신중한 정책이 필요하다.
-
embodied AI의 병목을 풀려면 정확도뿐 아니라 불확실성 속에서 OUCH가 가장 낮은 행동을 선택해야 한다.