9월 19일 토요일
오늘의 두 설계는 자동화의 속도보다 제어권의 위치를 묻는다. 네트워크는 혼잡을 보는 수신자에게, 현대화는 업무 의미를 아는 검증자에게 결정을 가까이 둔다.
꼬리 지연을 줄이는 제어권 재배치
Homa는 스트림과 송신자 중심 제어를 버리고 메시지 길이, 수신자 그랜트, 우선순위 큐를 하나의 전송 정책으로 묶는다.
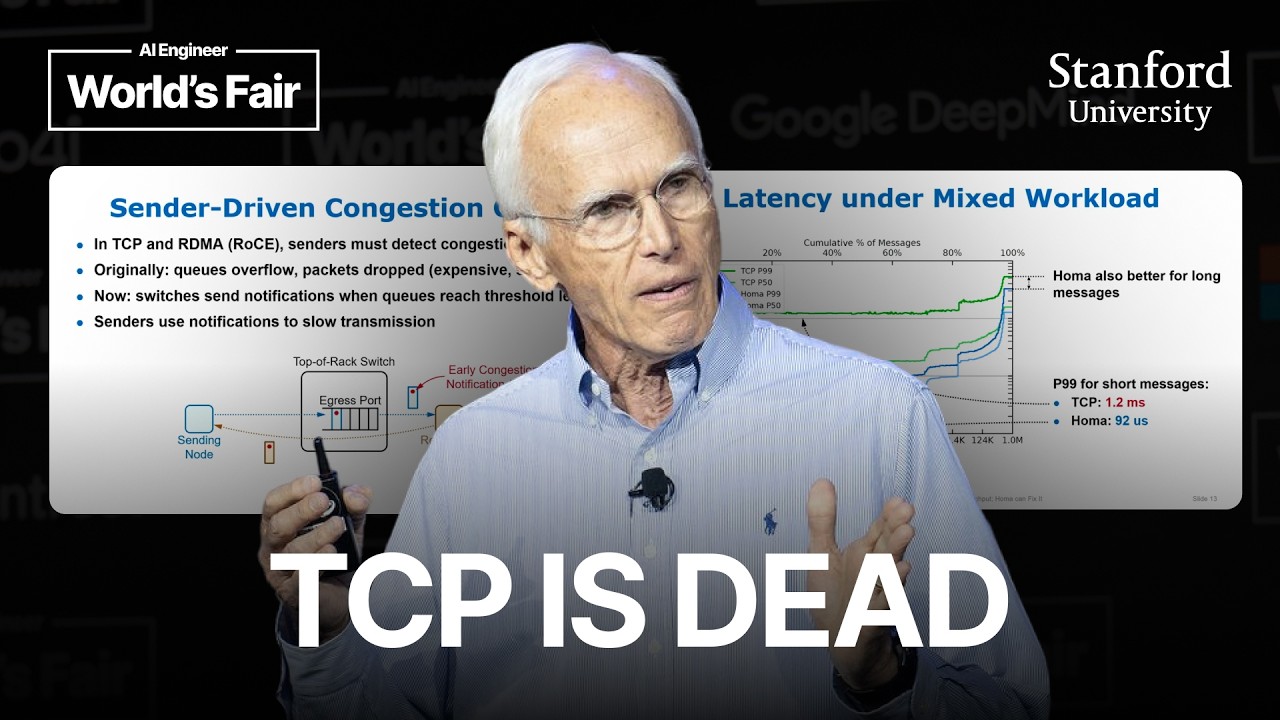
AI 추론·에이전트 클러스터에서 짧은 메시지의 P99를 낮추려면 전송 계층의 무엇을 바꿔야 하는가?
학습에서 오가던 기가바이트급 그래디언트와 가중치에는 링크 처리량이 핵심이었지만, 추론과 에이전트 작업은 분산 KV 캐시 조회, 메타데이터 교환, 배리어 동기화처럼 짧은 왕복을 늘린다. 계산 구간도 밀리초 단위로 짧아지면 한 메시지의 지연이 여러 GPU의 다음 계산을 막는다. 이때 평균보다 P99가 중요하다. TCP와 RDMA는 메시지 경계를 잃은 바이트 스트림과 송신자 중심 혼잡 제어를 사용한다. 여러 송신자가 한 수신자로 몰리는 인캐스트가 생기면 마지막 이그레스 포트에 긴 패킷이 쌓이고, 뒤늦게 온 짧은 메시지는 그 큐를 기다린다. ECN도 수신자를 거쳐 송신자에게 돌아간 뒤 전송률을 조정하므로, 제어가 안정될 즈음 네트워크 상태가 바뀔 수 있다. Homa의 답은 혼잡을 직접 보는 수신자에게 스케줄링 권한을 옮기고, 스트림 대신 길이가 알려진 메시지를 다루는 것이다.
- 01
메시지 경계를 보존한다
Homa의 기본 단위는 요청과 응답으로 이뤄진 RPC 메시지다. 첫 패킷을 받은 수신자는 전체 길이와 남은 양을 알 수 있다. 이 정보가 있어야 최단 잔여 처리 시간 우선, 즉 SRPT로 짧은 메시지를 식별하고 긴 메시지와 독립적으로 우회시킬 수 있다. 바이트 스트림에서 생기는 헤드 오브 라인 블로킹을 데이터 모델부터 제거하는 선택이다.
- 02
수신자가 유입량을 허가한다
송신자는 처음 몇 개의 비예약 패킷만 바로 보내고, 나머지 예약 패킷은 수신자의 그랜트를 기다린다. 수신자는 여러 메시지에 허가를 한꺼번에 내리지 않고 시간에 따라 분배해 마지막 홉 큐의 유입을 조절한다. 송신자가 여러 왕복 뒤 혼잡을 추정하는 구조와 달리, 병목 위치의 관측자가 어느 송신자에게 다음 데이터 덩어리를 허용할지 결정한다.
- 03
소프트웨어 정책을 스위치 큐에 투영한다
그랜트 순서만으로 끝나지 않는다. Homa는 메시지 길이에 따라 스위치 이그레스 포트의 여러 우선순위 큐를 동적으로 고른다. 긴 전송이 낮은 큐에 쌓여 있어도 짧은 메시지는 높은 큐로 통과한다. 수신자 스케줄링과 하드웨어 큐가 같은 SRPT 정책을 실행하기 때문에 짧은 요청의 대기 시간을 직접 줄일 수 있다.
- 04
벤치마크와 적용 경계를 함께 본다
약 50바이트부터 1메가바이트까지 섞은 요청·응답 벤치마크에서 TCP의 짧은 메시지 P99는 1밀리초를 넘었고 Homa는 100마이크로초 미만으로, 발표 기준 약 13배 빨랐다. 긴 메시지도 거의 2배 개선됐다. 그러나 이는 특정 혼합 작업 부하의 결과다. 실제 도입 판단은 메시지 크기 분포, 인캐스트 패턴, 계산·동기화 구간, GPU 유휴 시간을 먼저 측정한 뒤 Linux 커널 모듈로 재현해야 한다. 메인라인 반영 절차가 진행 중이라는 구현 상태도 운영 채택과 구분해야 한다.
Homa의 핵심은 단순한 TCP 튜닝이 아니다. 작업 부하가 대형 전송에서 짧은 메시지 혼합으로 바뀌면, 전송 단위를 메시지로 되돌리고 병목을 보는 수신자에게 제어권을 주며 스위치 우선순위까지 연결해야 한다는 설계 주장이다. 평가도 평균 왕복 시간만으로는 부족하다. P50과 P99, 애플리케이션 처리량, GPU 대기 시간을 함께 비교해야 짧은 메시지 우선 정책이 실제 시스템 병목을 없앴는지 판단할 수 있다. 발표의 수치는 시험할 가설이지 모든 AI 클러스터에 자동으로 적용되는 보장이 아니다.
AI 변환을 안전한 현대화로 만드는 검증 사슬
레거시 코드를 빠르게 번역하는 것과 수십 년의 업무 의미를 보존하는 것은 다른 문제다. 분석부터 배포까지 단계마다 검증 경계를 둬야 한다.
AI 기반 레거시 현대화에서 변환 속도와 업무 의미 보존을 어떻게 같은 워크플로우에 넣는가?
- 1
1. 발견
LLM이 전체 코드베이스를 읽고 모듈의 역할, 데이터 흐름, 핵심 도메인 로직의 위치를 자연어로 지도화한다. 문서와 원 개발자가 사라진 환경에서 수개월 걸리던 발견 단계를 수주로 줄일 수 있지만, 이 지도는 안전한 변환의 완료가 아니라 검토할 출발점이다.
- 2
2. 계획
에이전트는 분석 결과를 바탕으로 현대화 순서를 만든다. 목표는 언어만 바꾸는 것이 아니라 아키텍처, 기술 스택, 개발 프로세스를 함께 진화시키는 것이다. 강하게 결합된 모놀리스를 작은 독립 서비스로 나누고, 기존 업무를 계속 운영하면서 점진적으로 옮기는 범위를 정한다.
- 3
3. 변환
AI는 COBOL을 Java로, C를 Python으로 옮기고 오래된 배치 스크립트를 이벤트 기반 또는 서버리스 함수로 바꿀 수 있다. 그러나 새 문법과 실행 모델을 얻는 것보다 원래 로직과 의도를 보존하는 것이 우선이다. 문법적으로 맞는 코드는 동작까지 같다는 증거가 아니다.
- 4
4. 검증
에이전트가 테스트와 문서를 만들더라도 테스트, 인간 검토, 실제 결과 검증은 마이그레이션 전 과정에 남아야 한다. 특히 문서화되지 않은 예외 규칙, 하류 의존 관계, 보안과 운영 영향은 숙련 엔지니어가 판단한다. AI는 취약점 탐지를 도울 뿐 안전성을 자동 보증하지 않는다.
- 5
5. 점진적 배포
자동화 테스트와 지속적 배포를 통해 변경을 작은 단위로 자주 내보낸다. 빅뱅 전환 대신 서비스와 검증 단위를 나누면 기존 업무를 유지하면서 영향 범위를 제한할 수 있다. 경험 많은 엔지니어는 반복 변환보다 마이그레이션 승인과 고위험 판단 가까이에 배치한다.
- 6
6. 세 축을 함께 바꾼다
코드 번역만 완료하면 낡은 결합 구조와 배포 방식은 그대로 남는다. 현대화는 모놀리스를 독립 서비스로 나누는 아키텍처, 오래된 언어·프레임워크·온프레미스 인프라를 바꾸는 기술 스택, 자동화 테스트와 지속적 배포를 도입하는 개발 프로세스를 함께 다룬다. 세 축을 분리하면 새 언어 위에 기존 위험을 다시 만들 수 있다.
- 7
7. 성공 기준을 번역량에서 옮긴다
완료 기준은 변환한 파일 수가 아니라 핵심 업무 로직이 유지되고 시스템이 더 쉽게 수정·확장되며 작은 변경을 안전하게 반복할 수 있는가다. 현대 플랫폼의 보안 업데이트와 클라우드 통합 이점도 기대할 수 있지만, AI가 기존 취약점을 모두 제거하거나 생성 코드의 안전성을 보장하지는 않는다. 그래서 보안과 운영 영향의 승인 책임은 계속 경험 많은 엔지니어에게 남는다.
AI 현대화의 구현 단위는 모델 호출이 아니라 발견→계획→변환→테스트→문서화→검토→점진적 배포로 이어지는 검증 사슬이다. 속도는 앞단의 반복 작업에서 얻고, 신뢰는 원래 업무 결과와 보안·운영 영향을 사람이 확인하는 뒷단에서 만든다. 컴파일과 기본 테스트 통과만으로 의미 보존을 선언하지 않는 것이 이 설계의 핵심 경계다.
아직 못 읽은 북마크
북마크를 고르는 중…